Read modely, projekce a výkon
Read modely, projekce a výkon DDD aplikace nad Symfony a Doctrine ORM: N+1 dotazy, dopad hranic agregátů, stavba projekcí, snapshoty a cache read modelů.
Obsah kapitoly
16.01 Výkon v kontextu DDD#
Pověst pomalého DDD se opírá o anekdoty místo měření. Výkonnostní problémy přicházejí ze špatné implementace: příliš velkých agregátů, nevhodného lazy loadingu, chybějícího read modelu. Doménový model rychlou aplikaci nevylučuje.
Výkon se stává kritickým ve třech scénářích: u aplikací s desítkami propojených agregátů, u velkých agregátů s kolekcemi tisíců položek a u systémů s vysokou frekvencí čtení. Poslední skupina navíc potřebuje odezvu v desítkách milisekund.
Kapitola má dvě poloviny, které se nesmějí plést. Sekce 16.02, 16.03, 16.06 a 16.08 mluví o write straně: o agregátu, Unit of Work a dávkovém zápisu. Limitem je tam konzistence, takže žádná optimalizace nesmí porušit invariant. Sekce 16.04, 16.07 a část 16.09 patří read straně: dotazu, projekci, cache a replice. Invariant tam nikdo nedrží, proto se data smějí denormalizovat, duplikovat i vracet zastaralá. Rada platná na jedné straně na druhé často škodí.
16.02 N+1 problém a lazy loading v Doctrine#
N+1 je typický anti-vzor každého ORM bez výslovně zvolené fetch strategie. Aplikace provede jeden dotaz pro seznam entit a poté pro každou z nich načte asociovaná data zvlášť – celkem N+1 SQL příkazů místo jednoho či dvou.
Pro kolekce (OneToMany, ManyToMany) Doctrine ve výchozím stavu používá lazy loading: kolekce zůstává neinicializovaná, dokud k ní kód poprvé nepřistoupí. Když kód kolekci vůbec nepoužije, je to výhoda. Při iteraci přes mnoho agregátů to ale plodí výše popsaný N+1 problém.
Řešení 1: EXTRA_LAZY kolekce
Doctrine nabízí strategii EXTRA_LAZY pro kolekce. Standardní lazy loading načte při prvním
přístupu celou kolekci. EXTRA_LAZY místo toho vyřídí count(), contains()
nebo slice() přímými SQL dotazy a do paměti kolekci vůbec nenačte.
Řešení 2: Fetch join v DQL pro eager loading
Když je předem jasné, že se bude iterovat přes kolekce, je efektivnější fetch join v DQL:
alias joinované asociace se přidá do klauzule SELECT (SELECT o, i). Doctrine pak načte
agregát včetně asociovaných objektů v jediném SQL dotazu s LEFT JOIN nebo INNER JOIN.
Při kombinaci fetch joinu s paginací (setMaxResults(), setFirstResult())
Doctrine žádné varování nevypíše. LIMIT se aplikuje na řádky SQL výsledku, ve kterých se
kořenová entita kvůli joinu opakuje. Hydratace pak tiše vrátí méně entit nebo oříznuté kolekce.
Řešením je Doctrine\ORM\Tools\Pagination\Paginator, který nejdřív vybere identifikátory
kořenových entit pro danou stránku a teprve pak k nim načte data, případně nativní SQL
s vlastním mapováním výsledků.
Paginator má ale svou cenu. Ve výchozím nastavení vydá tři dotazy: COUNT s DISTINCT,
poddotaz s identifikátory kořenových entit pro danou stránku a finální WHERE IN.
Parametr konstruktoru $fetchJoinCollection: false sníží počet na dva a je namístě tam,
kde dotaz joinuje jen to-one asociace. DISTINCT v počítacím dotazu lze potlačit hintem
Paginator::HINT_ENABLE_DISTINCT. Konstanta patří třídě Paginator, nikoli Query.
Agregační funkce v SELECT se s fetchJoinCollection: true chovají nepředvídatelně;
pro dotaz se SUM() nebo COUNT() je lepší napsat vlastní počítací dotaz.
Řešení 3: eager fetch po dávkách
U kolekce mapované jako fetch: 'EAGER' Doctrine nevydá JOIN. OneToMany kolekci načte druhým
dotazem, který obslouží několik kořenových entit najednou. Velikost dávky má výchozí hodnotu 100
a nastavuje ji Configuration::setEagerFetchBatchSize(int $batchSize = 100). Z N+1 dotazů
se tak stane N/100 + 1 a mechanismus běží i bez explicitní konfigurace.
Dávkování se netýká ManyToMany: eager ManyToMany kolekce stojí jeden dotaz na každého rodiče,
takže N+1 zůstává. Totéž platí pro OneToMany s indexBy nebo se složeným cizím klíčem.
Háček: EAGER v mapování platí globálně, i pro dotazy, které asociaci vůbec
nepotřebují. Dokumentace ORM proto doporučuje řešit N+1 primárně fetch joinem v DQL.
Eager mapování zůstává poslední volbou pro asociace, které se načítají prakticky vždy.
Hluboké stránkování a keyset paging
Řádky před OFFSET databáze nepřeskočí, musí je projít a zahodit. Na první
stránce je to neměřitelné, na pětitisící stránce je stejný dotaz o řád pomalejší. Druhý
problém je drift: mezi dvěma požadavky přibude záznam, seznam se posune a čtenář uvidí
na další stránce položku, kterou už četl.
Keyset paging (seek metoda) místo offsetu použije hodnoty poslední položky předchozí stránky
jako predikát. Podmínka musí obsahovat celý ORDER BY včetně unikátního sloupce, jinak se
na hranici stránky ztratí záznamy se shodným časem.
Read model má vlastní tabulku, takže index se navrhuje přímo k dotazu, který ji čte, ne ke schématu domény. Na write straně naopak indexy slouží hlavně vyhledání agregátu podle identity. Cenou keyset pagingu je ztráta skoku na libovolnou stránku: seek metoda umí „další“ a „předchozí“, nikoli „stránka 137“.
16.03 Agregát a výkon: správné určení hranic#
Agregát drží konzistenční hranici: invarianty platí uvnitř jednoho agregátu. Příliš široce nakreslená hranice znamená, že agregát tahá z databáze rozsáhlý objektový graf, i když operace potřebuje jen malou část dat.
Řešení: rozdělení agregátu a specializované repozitářní metody
Nejdřív se přezkoumá, zda OrderItem skutečně musí být součástí
agregátu Order, nebo zda jde o samostatný agregát s odkazem na OrderId.
Rozhoduje invariant. Pokud objednávka nedrží žádné pravidlo přes celou kolekci
(limit počtu položek, minimální hodnota košíku), kolekce v agregátu nemá co dělat.
Její vyčlenění je pak oprava návrhu, ne výkonnostní trik.
Výkon může v úvaze vystupovat dvojím způsobem. Jako signál špatně vedené hranice je oprávněným podnětem: pomalé načítání ukazuje na kolekci, která nikdy součástí invariantu nebyla. Jako důvod rozbít invariant ale neobstojí. Odpovědí tam zůstává read model, ne přesun pravidla mimo agregát. Podrobně rozebírá velikost agregátu sekce Velikost agregátu a její dopady.
Hranice agregátu vede přes doménové invarianty, výkonnostní požadavky se řeší jinde. Evans i Vernon ji vedou stejně, tedy přes pravidlo, které musí platit v jedné transakci. Když výkon tlačí proti doménovému modelu, odpovědí je read model (viz následující sekci), ne porušení doménové integrity.
16.04 Optimalizace read modelu (CQRS)#
Oddělení write side (operace přes agregáty) od read side (dotazy do prezentace) je nejsilnější páka na výkonnostní problémy v DDD. Read side doménové objekty nepotřebuje a vrací rovnou strukturu dat pro UI nebo API klienta.
Zároveň je to páka s nejvyšší cenou. Martin Fowler o CQRS píše, že „for most systems CQRS adds risky complexity“. Případy, které viděl, popisuje spíš jako zdroj potíží než jako záchranu. Nasazovat ho doporučuje na jednotlivý Bounded Context, nikdy plošně [2]. Kompletní seznam kompromisů drží sekce Výzvy a omezení CQRS. Než tedy dotaz skončí v samostatném read modelu, vyplatí se projít levnější stupně.
Dotaz se drží jednoho agregátu a zákazníka nese jen jako customerId. Jméno zákazníka leží
v jiném agregátu a DQL by pro něj potřebovala mapovanou asociaci Order → Customer, kterou
kniha na write straně zakazuje (viz Reference přes identitu).
Na read straně je spojení obou tabulek v pořádku. Dělá se ale o patro níž, v SQL nad
tabulkami, ne přes namapovaný objektový graf, jak ukazuje následující příklad.
Doctrine NativeQuery pro komplexní reportovací dotazy
DQL pokrývá většinu dotazů, na složité reportovací dotazy (agregace, window funkce, CTE)
ale nestačí. Pro ně Doctrine spouští nativní SQL s vlastním mapováním
výsledků přes ResultSetMapping.
16.05 UUID vs. integer primární klíče#
Agregát musí znát svou identitu už před uložením do databáze. Identifikátor se generuje v doménovém kódu bez databázové sekvence nebo auto-increment hodnoty. Pro distribuované systémy, event sourcing a paralelní vytváření agregátů to není volba, ale podmínka.
Časově řazené identifikátory: UUID v7 a ULID
ULID (Universally Unique Lexicographically Sortable Identifier) a UUID verze 6/7 (ordered UUID) řeší fragmentaci indexů tím, že jsou časově řazené. Nové hodnoty jsou až na drobné odchylky mezi generátory větší než předchozí a vkládají se na konec B-tree indexu. Chování se blíží auto-increment integeru, ale globální unikátnost zůstává a centrální generátor není potřeba. Tento průvodce používá UUID v7; ULID je alternativa s kratším Crockford base32 zápisem (26 znaků vs. 36).
16.06 Doctrine Identity Map a Unit of Work#
Doctrine ORM implementuje vzor Identity Map (Martin Fowler, Patterns of Enterprise Application
Architecture, Addison-Wesley, 2003).
Každý spravovaný objekt (managed entity) je v jednom EntityManageru uložen v paměti pod svým
identifikátorem. Pokud načtete tentýž agregát dvakrát přes find() podle ID, Doctrine podruhé
vrátí objekt z paměti bez SQL dotazu. Opakovaný DQL dotaz SQL provede, ale při hydrataci
vrátí existující instanci z Identity Map, nikoli novou kopii.
Problém s batch zpracováním
Identity Map počítá s typickým web requestem: jednotky až desítky agregátů. Hromadné zpracování (import, migrace, reporty) sype do Identity Map tisíce objektů, které tam zůstávají po celou dobu běhu. Spotřeba paměti roste, jako by aplikace měla memory leak, a dirty checking se zpomaluje, protože Doctrine musí procházet stále větší množinu spravovaných objektů.
Velikost dávky je empirická hodnota, ne konstanta z dokumentace. Dokumentace Doctrine radí
s ní experimentovat: větší dávka ušetří režii, ale prodlouží jeden flush(). Její vlastní
příklady pracují s dávkou 20. Optimum závisí na šířce řádku, počtu indexů
a nastavení databáze. Sto řádků v ukázce je výchozí bod, ne cíl.
Read-only entity a rozsah dirty checkingu
Dirty checking při každém flush() porovnává aktuální stav spravovaných objektů s jejich
snímkem z okamžiku načtení. U referenčních dat je to čistá ztráta: číselníky, katalog ani
sazebník se během jednoho běhu nemění. První pákou jsou read-only entity.
#[ORM\Entity(readOnly: true)] označí celou třídu, UnitOfWork::markReadOnly() jednu
instanci pro daný běh. Změny takového objektu flush() do databáze nezapíše.
Druhou pákou je strategie sledování změn. Výchozí DEFERRED_IMPLICIT prochází při flush()
všechny spravované objekty. Alternativa DEFERRED_EXPLICIT kontroluje jen objekty, které kód
explicitně předá persist(); ušetří práci, ale zapomenuté persist() znamená tiše neuloženou
změnu. Pro běžný web request je výchozí nastavení v pořádku, v dávkovém běhu stojí za zvážení.
16.07 Caching v DDD architektuře#
Cache patří na výsledky, které jsou výpočetně nebo I/O nákladné a v čase se nemění (nebo se mění předvídatelně). Slouží infrastruktuře, ne doménovým rozhodnutím.
Query cache a result cache v Doctrine
Doctrine nabízí dvě úrovně cachování SQL dotazů:
- Query cache: cachuje překlad DQL → SQL. Parsování DQL je relativně drahé a query cache ho u opakovaných dotazů ušetří. Překlad DQL na SQL se v čase nemění, takže tuto cache není třeba invalidovat.
- Result cache: cachuje výsledky SQL dotazu. Zapíná se na konkrétním dotazu metodou
enableResultCache(?int $lifetime, ?string $resultCacheId). Vhodná pro read-heavy dotazy s řízenou dobou platnosti.
Result cache se neinvaliduje doménovou událostí, ale klíčem. Buď dotazu předáte vlastní
$resultCacheId a ten po změně dat smažete přes $em->getConfiguration()->getResultCache(),
nebo klíč odvodíte od dat (například z času poslední změny) a starý záznam necháte vypršet.
Bez pojmenovaného klíče si Doctrine vygeneruje hash z SQL a parametrů, který v aplikačním kódu
nemáte jak zopakovat. Takový dotaz lze zneplatnit jen vypršením TTL.
Vedle toho existuje Second Level Cache, která cachuje samotné entity a kolekce v režimech
READ_ONLY, NONSTRICT_READ_WRITE a READ_WRITE. Dokumentace ji stále označuje za
experimentální a tento průvodce ji nepoužívá: cache na úrovni read modelu řeší totéž
srozumitelněji a bez vazby na životní cyklus entit.
Cache drží hotový ViewModel, ne doménový agregát. Serializace agregátu je křehká: po deserializaci vznikne objekt odpojený od Unit of Work (detached), lazy proxy asociací přestanou fungovat a obejde se Identity Map. ViewModel z prostých hodnot tyto problémy nemá. Odpovídá to zásadě z calloutu výše: do cache patří výsledky read modelu, ne stav agregátů.
Ukázka používá Cache Contracts (Symfony\Contracts\Cache\CacheInterface), ne holé PSR-6.
Kromě kratšího kódu drží Contracts po dobu výpočtu zámek, takže při vypršení záznamu
přepočítá hodnotu jen jeden proces a ostatní na témže serveru počkají. K tomu Contracts ve výchozím
stavu ($beta = 1.0) používají pravděpodobnostní předčasnou expiraci: čím blíž je záznam konci platnosti, tím větší šance,
že ho jeden náhodně vybraný požadavek přepočítá dřív, než vyprší. Obojí brání cache stampede,
kdy po expiraci horkého klíče spustí tentýž dotaz stovky souběžných požadavků najednou.
Holé PSR-6 přes CacheItemPoolInterface zůstává pro interoperabilitu s knihovnami třetích stran.
Cache invalidace při doménových událostech
Cache se v DDD nejlépe invaliduje nasloucháním doménovým událostem. Když agregát změní stav a nahraje doménovou událost, listener zneplatní příslušné záznamy. Invalidace tak navazuje na doménový tok místo ad-hoc volání rozptýlených po kódu.
Ukázka počítá s událostí UserEmailChanged. Kanonický User z kapitoly
Implementace v Symfony 8 ji nemá,
jeho changeEmail() žádnou událost nenahrává. Zde jde o rozšíření: metoda by po změně
adresy zavolala $this->record(new UserEmailChanged($this->id, $newEmail)).
Jedna doménová událost typicky zneplatňuje víc odvozených pohledů, ne jeden klíč. Právě proto
listener maže tag, nikoli položku: seznam, detail i dlaždice na dashboardu nesou stejný tag
a zmizí jedním voláním. Tagy vyžadují pool s podporou tagování: v konfiguraci framework.cache
buď tags: true, nebo adaptér cache.adapter.redis_tag_aware. Ručně se pak dá skupina
zneplatnit i z konzole příkazem cache:pool:invalidate-tags.
16.08 Bulk operace a hromadné zpracování#
Standardní DDD postup počítá s jednotlivými agregáty: načíst agregát, aplikovat doménovou
logiku, zavolat flush(). Pro hromadné operace (import tisíců záznamů,
hromadná aktualizace stavů, migrace dat) je neefektivní. Každý cyklus přidá
agregát do Identity Map a dirty checking při flush() prochází všechny spravované objekty.
Bez průběžného clear() proto roste spotřeba paměti i doba jednoho flush(): každý další
zápis porovnává větší množinu objektů než ten předchozí.
DQL bulk UPDATE a DELETE – bypass Identity Map
Hromadné aktualizace, které nemusí procházet doménovou logikou, zvládne Doctrine
přímo jako DQL UPDATE nebo DELETE. Ty obcházejí Identity Map i Unit of Work,
protože jde o přímé SQL příkazy přeložené z DQL. Nevýhoda:
po DQL bulk operaci jsou spravované entity v Identity Map nekonzistentní se stavem v databázi.
DQL UPDATE navíc změní jen vyjmenované sloupce, takže verzi z #[ORM\Version] nezvýší.
Souběžný zápis přes agregát, který si řádek načetl dřív, pak konflikt nepozná a hromadnou
změnu přepíše. U verzované entity proto patří do SET i o.version = o.version + 1.
Obvyklá rada zní zavolat clear(). V ORM 3 ale clear() argument nepřijímá, takže odpojí
úplně všechno, včetně rozdělané práce volajícího. Bezpečnější pořadí je pustit bulk operaci
dřív, než se do entity manageru cokoli načte, nebo ji provést nad samostatným entity managerem
vyhrazeným pro údržbové úlohy. clear() na konci handleru je pak pojistka, ne oprava.
Dávkový zápis přes persist()/flush()/clear() ukazuje handler ze sekce
Identity Map a Unit of Work; stejný postup platí i pro import.
Ještě poznámka k ladění: setSQLLogger() je od DBAL 3.2 deprecated
a DBAL 4 ho odstranil. Logování se vypíná konfigurací (doctrine.dbal.logging: false)
nebo odebráním logovacího middleware, ne programaticky uprostřed dávky.
Čtení velkých výsledků po jednom
Zápis je jen půlka dávkové úlohy. Druhá půlka je čtení: getResult() zhmotní celý výsledek
do pole, takže milion řádků skončí v paměti PHP naráz. AbstractQuery::toIterable() vrací
Traversable a hydratuje po jednom řádku; metoda iterate(), kterou znají uživatelé ORM 2,
v ORM 3 zanikla. Platí u ní dvě omezení:
toIterable()nelze kombinovat s fetch joinem kolekce. Jeden agregát se v SQL výsledku roztáhne do několika řádků a hydratace po řádcích je nedokáže složit dohromady. Jde to proti doporučení ze sekce o N+1: v dávce se fetch join kolekcí nepoužívá.- Objekty vydané iterací zůstávají spravované. Bez průběžného
clear()se ušetří jen paměť za pole výsledků, ne za Identity Map.
Když stačí data, ne agregáty, je přímočařejší DBAL: Connection::iterateAssociative()
(a sourozenci iterateNumeric(), iterateKeyValue(), iterateAssociativeIndexed(),
iterateColumn()) vrací Traversable polí a ORM se do cesty vůbec neplete. Klientská knihovna
databáze si přitom může výsledek bufferovat mimo paměť PHP, takže memory_get_usage() úsporu
nemusí ukázat; spolehlivější je sledovat spotřebu celého procesu.
Symfony Messenger pro asynchronní hromadné zpracování
Velký import nemusí běžet v jediném synchronním procesu, kde jedna chyba ukončí celou dávku. Práci lze rozdělit na menší úlohy zasílané přes Symfony Messenger na asynchronní transport (RabbitMQ, Redis Streams, Amazon SQS). Každá zpráva zpracuje jeden agregát nebo malý batch a paměťové nároky i doba zpracování jedné zprávy jsou pak předvídatelné.
Odesláním zpráv práce nekončí, jen se přesune k workerům. PHP proces, který běží hodiny,
paměť postupně nasčítá, proto se worker spouští s limity a nechává se restartovat:
messenger:consume async_commands --memory-limit=128M --time-limit=3600 --limit=1000.
Transport async_commands je týž jako v konfiguraci Messengeru
a ImportProductChunk na něj musí mířit v routing:. Bez toho ho Messenger zpracuje
synchronně a rozdělení na chunky nic nepřinese. Restart řídí
supervisor nebo systemd, ne aplikace. Počet souběžných workerů má strop v databázi.
Každý drží vlastní spojení, takže deset workerů nad primary znamená deset dalších
připojení. Souvislost s poolingem rozebírá sekce Read replicy a connection pooling.
16.09 Provozní výkonové vzory#
Předchozí sekce řeší výkon na úrovni jednoho dotazu nebo jednoho agregátu. Aplikace v nepřetržitém provozu s reálnou zátěží naráží na problémy, které lokální profiling neukáže: souběžnost více klientů, databázi jako sdílený zdroj a provozní omezení Doctrine ve více procesech.
Hot aggregates a optimistic lock thrash
Hot aggregate je agregát, který současně mění mnoho klientů. Klasické
příklady: globální Inventory jednoho produktu při rozjezdu kampaně, Tournament
agregát s 1000 účastníky, kteří všichni paralelně potvrdí účast, nebo BankAccount
firmy s tisíci transakcí denně.
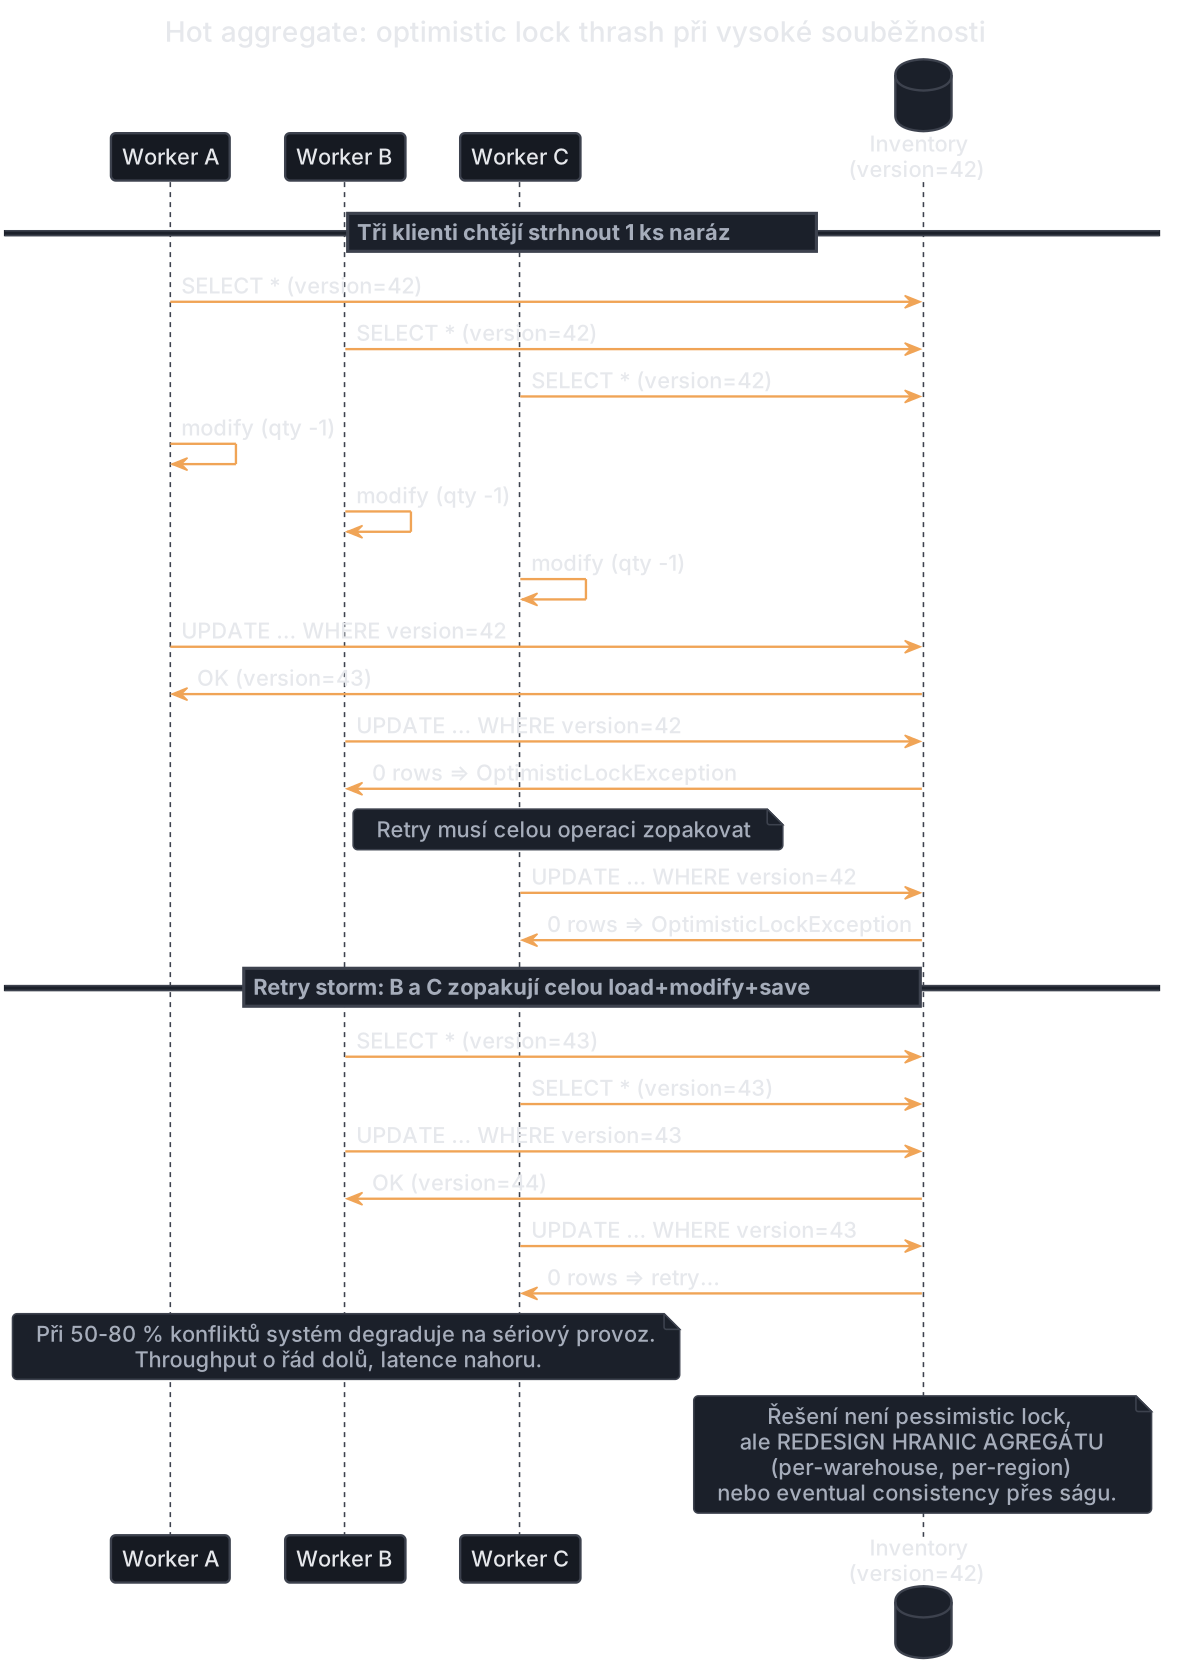
S #[ORM\Version] (optimistický zámek) vede souběžná modifikace k výjimkám
OptimisticLockException. Dokud jsou konflikty výjimečné, je retry levný: druhý pokus
projde. Jakmile konfliktů přibude, roste podíl práce, která končí zahozením. Systém
degraduje na sériový provoz a smyčka load → modify → save → conflict → retry spotřebuje
víc kapacity než samotné zpracování. Propustnost klesá, latence stoupá.
Kdy zlom nastane, žádné univerzální číslo neurčuje. Rozhoduje délka transakce, počet klientů
a to, jak často míří na tentýž agregát. Změřit to ale jde: podíl OptimisticLockException
na počtu pokusů o zápis daného agregátu je metrika, kterou má smysl sledovat trvale.
Strategie řešení rozebírá sekce Hot aggregate; z pohledu provozu jsou podstatné tři, v tomto pořadí:
- Nový návrh hranic agregátu. Horký
Inventoryčasto ve skutečnosti není jeden agregát, ale N samostatných agregátů, například jeden na sklad, region nebo SKU. Konflikty pak nevznikají mezi všemi klienty, jen mezi klienty téže lokace. - Eventual consistency místo silné konzistence. Místo „strhni 1 ks z
Inventorysynchronně“ se publikuje eventItemReserved(productId, qty)a agregát ho zpracuje asynchronně přes ságu. Konflikty řeší sága kompenzací, ne optimistický zámek. - CRDT / čistě čítačové agregáty. Když je doménová operace čistý increment
(
view_count,like_count), celý agregát není potřeba, stačí PostgresUPDATE counters SET n = n + 1 WHERE id = ?. Typické DDD to není, ale u skutečně komutativních operací jde o oprávněné řešení.
Partitioning velkých tabulek
PostgreSQL declarative partitioning je standardní řešení pro tabulky, které přerostly
paměť serveru a kde se aktivně mění jen poslední část (typicky podle created_at):
ordersdělená po měsících – aktivní partition drží jen poslední měsíc, takže se i s indexy vejde do cache. Staré partitions (read-only) mohou být na pomalejším disku nebo v archivu.audit_logdělená po dnech – po uplynutí retence se stará partition odpojí (DETACH PARTITION, od PostgreSQL 14 iCONCURRENTLY) a smaže. DlouhýDELETEnad aktivními daty odpadá.projection_*tabulky s vysokým write rate.
Pro DDD má partitioning jeden důsledek navíc. Když je tabulka dělená podle
created_at a doména zná jen OrderId, musí dotaz podle ID projít všechny
partitions. Řešení jsou dvě. Repozitář dostane partition key: created_at
(nebo odvozený měsíc) se přidá do hodnotového objektu OrderId a použije pro
partition pruning. Druhou cestou je dělit tabulku rovnou podle ID: UUID v7 nese
v nejvyšších bitech časovou složku, takže rozsahy ID odpovídají časovým obdobím.
Read replicy a connection pooling
V CQRS architektuře jsou read modely vhodný kandidát pro read replicy: samostatnou databázi (nebo Postgres streaming replicu), na kterou jdou všechny dotazy. Write model zůstává na primary. Důsledky pro DDD kód:
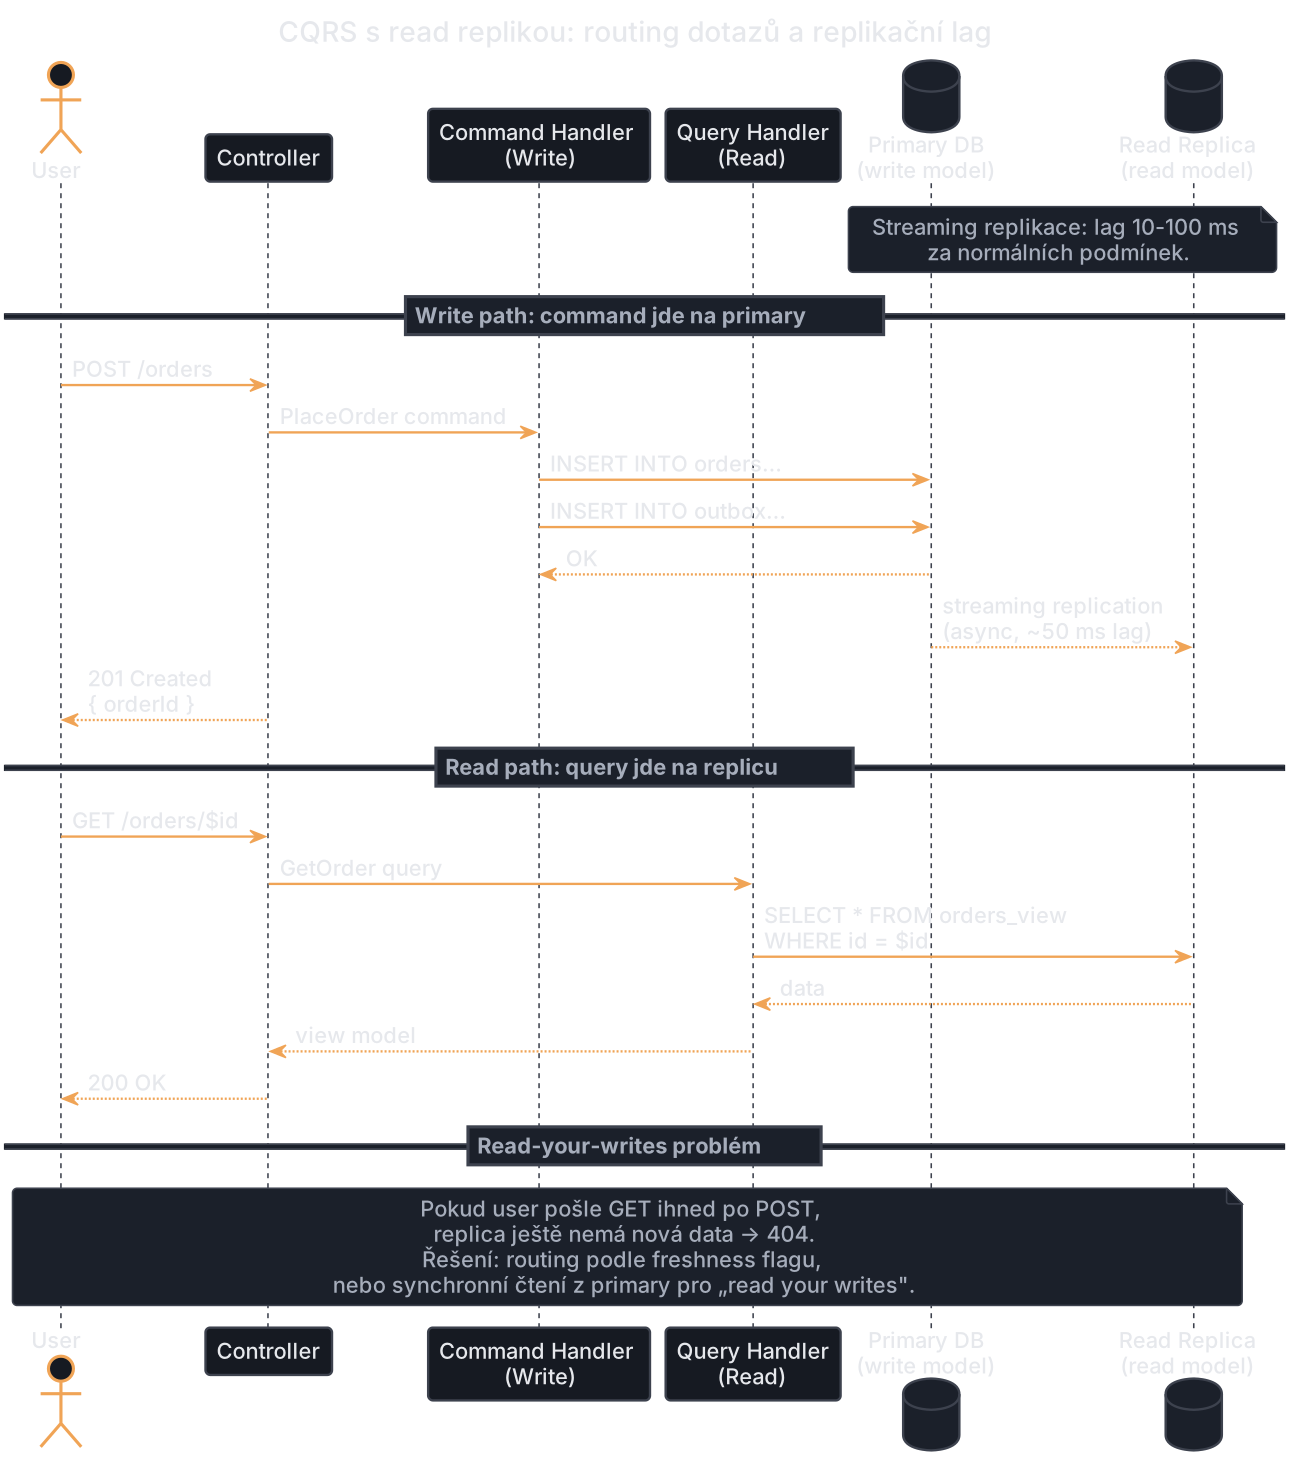
- Repozitář write strany drží
EntityManagerInterfacenamapovaný na primary. - Query handler read strany drží separátní
ConnectionneboEntityManagernamapovaný na replicu (doctrine.orm.read_entity_manager). - Replikační lag znamená, že dotaz na repliku nemusí hned po
save()na primary vidět změnu. Je to stejný „read your writes“ problém jako u eventual consistency. Vzor řešení viz CQRS – eventual consistency v UI. Velikost lagu je vlastnost konkrétního nasazení, ne konstanta. Na replice Postgresu ji dá rozdílnow() - pg_last_xact_replay_timestamp()a patří do monitoringu vedle latence dotazů.
Nejlevnější obranou proti „read your writes“ je routing, ne kód domény: po zápisu se relace na krátkou dobu přilepí na primary a čte odtud. Sticky routing řeší přesně tu chvíli, kdy uživatel odešle formulář a hned nato vidí výpis. Alternativa přes pozici zápisu v HTTP hlavičce je popsaná v sekci Read-your-writes na úrovni HTTP.
Identifikátor doctrine.orm.read_entity_manager platí jen tehdy, když je entity manager
tohoto jména nakonfigurovaný. Symfony pro každý manager vygeneruje službu
doctrine.orm.<název>_entity_manager a autowiring se řídí jménem parametru:
Asociace mezi entitami různých managerů Doctrine nepodporuje. Pro read model je to spíš výhoda: donutí to psát dotazy nad tabulkami, ne nad objektovým grafem přes hranice agregátů.
Connection pooling je samostatný problém. PHP-FPM model „1 worker = 1 PHP proces
= 1 DB connection“ se nasčítá: 4 aplikační pody × 100 PHP-FPM workerů
= 400 spojení na primary, tedy čtyřnásobek výchozího max_connections = 100
v Postgresu.
Standardní řešení je PgBouncer / RDS Proxy mezi aplikací a DB v režimu transaction
pooling. Pozor: transaction pooling sám o sobě prepared statements nepodporuje,
a Doctrine je používá. Řešením je buď session pooling (méně efektivní), nebo PgBouncer
od verze 1.21 s max_prepared_statements > 0. PgBouncer pak prepare od klienta zachytí,
přidělí mu interní jméno a na backendu ho v případě potřeby připraví znovu. Volbu
zavedla právě verze 1.21 s výchozí hodnotou 0, tedy vypnuto; ve výchozím stavu zapnutá
(200) je až od 1.24, na starší verzi se proto nastavuje explicitně. Podmínka: musí jít
o prepared statements na úrovni protokolu databáze, tedy PQprepare/PQexecPrepared
v libpq. SQL příkazy PREPARE/EXECUTE PgBouncer nesleduje. Konfigurační volba
prepared_statements = true neexistuje.
Projekce v provozu: zpoždění a rebuild
Jak projekci napsat, ukazují kapitoly CQRS a
Event Sourcing. Provozní půlka začíná až tam, kde ty končí:
u asynchronní projekce dělí zápis od jeho zobrazení vždy nějaké zpoždění. Synchronní
projekce pod doctrine_transaction zpoždění nemá, platí za to delší transakcí zápisu.
Měřit se dá přímo. Projektor si drží checkpoint, tedy pozici poslední zpracované události. Proti němu stojí hlava streamu. Rozdíl obou hodnot je projection lag a dá se vyjádřit dvojím způsobem: počtem nezpracovaných událostí a stářím té nejstarší z nich. První číslo říká, kolik práce zbývá, druhé, co uvidí uživatel. Do monitoringu patří obojí, protože projekce zaseknutá na jedné chybné události má lag v událostech malý a ve vteřinách rostoucí.
Rebuild je druhá provozní situace, kterou je lepší naplánovat předem. Přehrání celého streamu do prázdné tabulky trvá tím déle, čím delší stream je, a po celou dobu není projekce použitelná. Osvědčený postup:
- Nová tabulka nebo schéma vedle stávající projekce, plnění z počátku streamu (blue/green).
- Čtení mezitím obsluhuje stará tabulka, dokud nová nedožene hlavu streamu.
- Přepnutí je přejmenování tabulky nebo změna konfigurace čtecí strany, tedy operace v řádu milisekund.
- Stará tabulka zůstává ještě jeden provozní den jako záchranná cesta zpět.
Rebuild čte a zapisuje naplno, takže bez omezení dokáže zahltit tutéž databázi, ze které čtou uživatelé. Řešení jsou dvě: pustit rebuild proti replice a zapisovat do oddělené instance, nebo dávku brzdit. Pevná velikost dávky a krátká pauza mezi nimi drží zatížení pod kontrolou za cenu delšího běhu.
Poslední otázka bývá, kdy projekci naopak zrušit. Pokud dotaz nad write modelem doběhne v jednotkách milisekund a data se čtou jednou za den, projekce přidává provozní náklad bez užitku. Tabulka, kterou nikdo nečte, ale kterou udržuje projektor, je čistá ztráta.
Snapshotting v Event Sourcingu (přehled)
Při Event Sourcingu (kapitola Event Sourcing) roste doba rekonstrukce
stavu agregátu lineárně s počtem eventů. Pro agregát se 100 eventy je okamžitá, u
1000 eventů začíná být znát a u 100k+ eventů (dlouho žijící agregát jako
UserAccount po letech provozu) je hydratace nepoužitelná.
Snapshot je zhuštěný stav agregátu uložený periodicky:
- Po každých N eventech se uloží
Snapshot{aggregateId, version, state}. Snapshot se zavádí, až když replay měřitelně zpomalí; to bývá u stovek až tisíců událostí. Interval (v ukázce kapitoly Event Sourcing 50) je laditelný parametr, ne doporučení. Závisí na velikosti stavu a poměru čtení k zápisu. - Při hydrataci se načte poslední snapshot a jen eventy novější než jeho verze.
- Cena: rychlejší čtení, ale snapshot tabulka roste a její struktura je vázaná na konkrétní verzi agregátu (problém evoluce schématu, viz Event Sourcing – verzování).
Detailní implementace včetně Symfony kódu je v sekci Event Sourcing – Snapshotting. Z pohledu výkonu platí: snapshot není výchozí volba, ale úniková páka pro dlouho žijící agregáty. Většina DDD agregátů má desítky eventů za celý životní cyklus a snapshotting nepotřebuje.
16.10 Profiling DDD aplikací#
Úzké místo nepoznáte bez měření. Pro PHP/Symfony jsou po ruce čtyři vrstvy nástrojů: vývojový profiler, produkční profiling, programatický logger SQL dotazů a komponenta Stopwatch. Ta poslední je nejlevnější: běží bez rozšíření i v produkci a změří věci, které Profiler nevidí – třeba dobu jednoho běhu projektoru nebo zpracování jedné Messenger zprávy.
Symfony Profiler (Web Debug Toolbar)
Ve vývojovém prostředí odhaluje N+1 a pomalé dotazy nejdřív Symfony Profiler
(aktivní při APP_ENV=dev). Panel Doctrine zobrazuje:
- Celkový počet SQL dotazů za request. Nadměrné číslo signalizuje N+1 problém.
- Dobu trvání každého dotazu; pomalé dotazy vyžadují index nebo přepis.
- Kompletní SQL s parametry, takže dotaz jde rovnou vyzkoušet v databázovém klientovi.
- Stack trace ke každému dotazu, který ukáže, která část kódu dotaz vydala. Sbírá se až
po zapnutí volby
profiling_collect_backtraceu DBAL spojení.
Doctrine query logging
V dev prostředí pokrývá počítání dotazů panel Doctrine v Profileru. Ten zapíná volba
doctrine.dbal.profiling, ve výchozím stavu aktivní v debug režimu; logging řídí
jen zápis dotazů do loggeru. Vlastní middleware má smysl jinde: v integračním testu,
kde na počet dotazů míří aserce („načtení seznamu objednávek nesmí vydat víc než dva
dotazy“), nebo při ladění dávky, která v Profileru vůbec neskončí.
Middleware se registruje jako služba se štítkem doctrine.middleware. V testu pak stačí
zavolat reset() před scénářem a getQueryCount() po něm. Aserce na počet dotazů odhalí
regresi typu „někdo odstranil fetch join“ dřív než produkční monitoring.
Blackfire.io pro produkční profiling
Pro profiling v produkčním nebo stagingovém prostředí se v PHP běžně používá Blackfire.io. Zachytí kompletní call graph profilovaného requestu nebo CLI příkazu včetně doby trvání, počtu volání a paměťové stopy každé funkce. Nad profily lze psát výkonnostní testy (Blackfire Builds), které v CI/CD pipeline zachytí výkonnostní regrese.
Runtime optimalizace Symfony
Jedna skupina zásahů se doménového modelu nedotkne vůbec a přitom zrychlí každý request:
nastavení běhového prostředí. Symfony pro produkci doporučuje OPcache s předehřátím
(opcache.preload mířící na config/preload.php), vypnutou kontrolu časových razítek
(opcache.validate_timestamps=0), dostatečnou opcache.memory_consumption
a opcache.max_accelerated_files nad počtem souborů projektu. K tomu patří zvětšená realpath
cache (realpath_cache_size, realpath_cache_ttl), autoloader vygenerovaný přes
composer dump-autoload --no-dev --classmap-authoritative a v konfiguraci kontejneru
.container.dumper.inline_factories: true.
Žádná z těchto voleb nezmění ani řádek doménového kódu. Než tedy padne rozhodnutí rozdělit agregát kvůli výkonu, vyplatí se ověřit, že aplikace v produkci vůbec běží s předehřátým OPcache. Jinak měření vypovídá o čemkoli jiném než o doménovém modelu.
Tři páky výkonu v DDD jsou hranice agregátů, read model a profiling. Práce začíná vždy měřením. Následují levné zásahy (N+1, indexy, dotaz mimo ORM) a teprve potom read model podle žebříčku eskalace. Hranice agregátu se přesouvá jen tehdy, když měření odhalí kolekci, která k invariantu nepatří. Pokračováním je kapitola Testování DDD.
Časté otázky
Zpomaluje DDD aplikaci oproti CRUD?
Samotné DDD výkon nesnižuje. Doménové třídy jsou čisté PHP bez běhové režie. Zpomalení nastává, když je špatně navržený agregát (načte víc dat, než je třeba). Další příčinou je chybějící read model v CQRS nebo nesprávné použití Doctrine lazy loadingu, které vede k N+1 dotazům. Explicitní hranice naopak optimalizaci usnadňují: je zřejmé, co se načítá kvůli invariantu a co jen kvůli zobrazení. Viz sekci Výkon v kontextu DDD.
Jak v DDD řešit N+1 problém s agregáty?
N+1 vzniká, když aplikace ke každému načtenému objektu dotahuje jeho vnitřní prvky samostatným dotazem. První volbou je fetch join v DQL (SELECT o, i FROM Order o LEFT JOIN o.items i) v metodě repozitáře. Pro čtení dat do UI bývá ještě přímočařejší denormalizovaný read model, který ORM lazy loading vynechá úplně. Až poslední volbou je fetch: 'EAGER' v mapování: u OneToMany kolekcí nevydá JOIN, ale druhý dotaz po dávkách (výchozí velikost 100; ManyToMany dávkování nemá), a platí globálně i pro dotazy, které asociaci nepotřebují. Rozbor řešení v sekci N+1 problém.
Má velikost agregátu vliv na výkon?
Ano. Příliš velký agregát tahá z databáze víc dat, než operace potřebuje. Pokud každá změna zvedá verzi kořene, vede navíc k častým konfliktům optimistického zamykání. Doctrine ji ale při změně potomka sám nezvedne, takže bez ručního zvednutí verze se místo konfliktu invariant tiše poruší (viz Anti-vzory). Správně zvolený agregát drží jen to, co musí být konzistentní v jedné transakci. Když dvě části agregátu nesdílejí invariant, jde zpravidla o dva samostatné agregáty. Rozdělení zvýší paralelismus i rychlost operací. Podrobný rozbor v sekci Agregát a výkon.
Jak optimalizovat read model v CQRS?
Read model se navrhuje přímo pro daný dotaz. Denormalizované tabulky odpovídají tvaru UI, nikoli doménovému modelu. Typické optimalizace jsou indexy navržené pro konkrétní filtry, materializované projekce místo JOIN dotazů nad write modelem nebo replikace read modelu na jiný datový stroj (Elasticsearch, Redis). Když jsou události uložené, lze read model přestavět z nich a změna jeho schématu nevyžaduje klasickou migraci. Detailní rozbor v sekci Optimalizace read modelu.
Je lepší UUID, nebo integer primární klíč z pohledu výkonu?
Integer klíč je rychlejší v indexech a zabírá méně místa, ale vyžaduje auto-increment generovaný databází. UUID umožňuje vygenerovat identitu v doméně bez round-tripu do DB, a přesně to DDD vyžaduje: agregát dostane ID před persistencí. Výkonový rozdíl závisí na databázovém stroji, šířce indexu a poměru zápisů ke čtení, takže obecné číslo neexistuje. U UUID v7 ale odpadá hlavní nevýhoda náhodných UUID, tedy fragmentace B-tree indexu. Pro DDD se UUID doporučuje. Srovnání obou variant v sekci UUID vs. integer primární klíče.