Outbox Pattern – spolehlivé publikování událostí
Objednávka je v databázi, ale než odejde událost OrderPlaced, spadne RabbitMQ. Odběratelé se o objednávce nedozvědí. Tomu se říká dual-write problem: Outbox Pattern ho řeší zápisem události v téže DB transakci, Inbox Pattern hlídá duplicity na straně odběratele. V Symfony 8 to je jeden Doctrine entity manager, jeden Messenger transport a zhruba 80 řádků kódu.
Obsah kapitoly
V kapitolách o CQRS, Event Sourcingu a ságách se opakovaně objevil stejný předpoklad: když agregát po commitu publikuje událost ven z kontextu, spolehlivě dorazí do message brokeru a odtud k subscriberům. Ten předpoklad neplatí. Mezi zápisem do databáze a dispatchem do Messenger transportu stojí síťový skok a dva nezávislé systémy, z nichž každý může selhat samostatně. Důsledkem je dual-write problem, jeden z nejčastějších zdrojů tichých nekonzistencí v event-driven architekturách.
Transactional Outbox Pattern je standardní řešení dual-write problému. Katalogovou definici vzoru formuloval Chris Richardson; Pat Helland k němu v práci Life Beyond Distributed Transactions (2007) dodává rámec: odmítnutí distribuovaných transakcí a požadavek na idempotentního příjemce. Protějšek na straně subscriberů se v katalozích jmenuje Idempotent Consumer, starším názvem Idempotent Receiver; tato kapitola pro něj používá pracovní jméno Idempotent Inbox, protože stojí symetricky proti outboxu.
15.01 Dual-write problem#
Nejjednodušší implementace publikování vypadá nevinně: po doménové operaci se stav
zapíše do databáze a událost se rovnou dispatchne na message bus. Takový kód projde
code review bez poznámek – dokud se v produkci nezačnou hromadit ztracené události a stížnosti subscriberů typu „vidím v API objednávku
12345, ale event OrderPlaced mi nikdy nedorazil“.
Krok 1 a krok 2 jsou dvě nezávislé transakce ve dvou různých systémech. Stačí mezi nimi jakákoliv chyba: síťový timeout, pád workeru, restart aplikace, výpadek brokera, OOM kill PHP procesu. Systém pak skončí v jednom ze dvou nesymetrických nekonzistentních stavů:
- Zápis do DB prošel, dispatch do brokera ne. Nastává tam, kde commit proběhne
před dispatchem – typicky bez middlewaru
doctrine_transaction, kdyflush()commitne vlastní transakci. Objednávka existuje v databázi, ale událostOrderPlacedse nikdy neodeslala. Subscriber kontext (Payment, Warehouse, Notifications) o objednávce neví. Zákazník ji vidí v API, ale platba se nestrhne, sklad nezarezervuje, e-mail nepřijde. Jde o nejhorší scénář: doménová událost se ztratí a v logu po ní nezůstane žádná stopa. - Dispatch do brokera prošel, zápis do DB ne. Pod middlewarem
doctrine_transactionje publish před commitem výchozí pořadí, ne chyba někoho, kdo kód přehází: middleware commitne až po návratu handleru. Commit pak může selhat po dispatchi, třeba kvůli optimistickému zámku. Subscribeři dostanou událost o objednávce, která fakticky neexistuje. Read model si přidá řádek, Payment se pokusí strhnout peníze za neexistující objednávku, Notifications odešle e-mail s odkazem na 404. Vznikne „phantom event“ – událost, která se ve zdrojové DB nestala.
Oba scénáře porušují atomicitu zápisu do dvou systémů a v event-driven architekturách nejsou vzácné. Pat Helland problém popsal v práci Life Beyond Distributed Transactions: An Apostate's Opinion (2007), termín dual-write ale nepoužívá. Zpráva odeslaná z transakce, která pak abortuje, podle něj způsobí efekt, na který systém nemá žádnou vzpomínku; transakční zařazení zpráv do fronty je proto nutnost. Jakmile transakce přesahuje hranici jednoho úložiště, databáze atomicitu nezaručí a musí ji obnovit aplikační logika. Ani slovo outbox v článku nepadne. Tabulku a relay proces popsal až Chris Richardson v knize Microservices Patterns (2018, kapitola 3) a v katalogu microservices.io. Jeho formulace řešení zní: odesílatel nejdřív uloží zprávu do databáze ve stejné transakci, která mění doménové entity, a samostatný proces ji teprve pak posílá do brokera. Jako alternativu katalog uvádí event sourcing.
Citace: Helland, P. Life Beyond Distributed Transactions: An Apostate's Opinion, CIDR (2007); Richardson, C. Microservices Patterns, Manning (2018), kapitola 3 – Transactional messaging; Microservices.io – Pattern: Transactional Outbox.
15.02 Transactional Outbox – princip#
Místo dispatchu do brokera se událost zapíše do tabulky outbox ve stejné databázi,
kde žije doménový stav, a to uvnitř stejné DB transakce jako úprava agregátu.
Buď se zapíše obojí (objednávka i její událost), nebo nic (rollback celé transakce).
Atomicita je zpátky: oba zápisy leží v jediné ACID transakci jedné databáze,
ne ve dvou různých systémech.
Samostatný proces (relay worker, někdy nazývaný publisher
nebo dispatcher) tabulku asynchronně polluje. Vybírá řádky se stavem
pending, publikuje je do skutečného message brokeru a po úspěšném publishi
je označí jako sent. Tok má čtyři fáze:
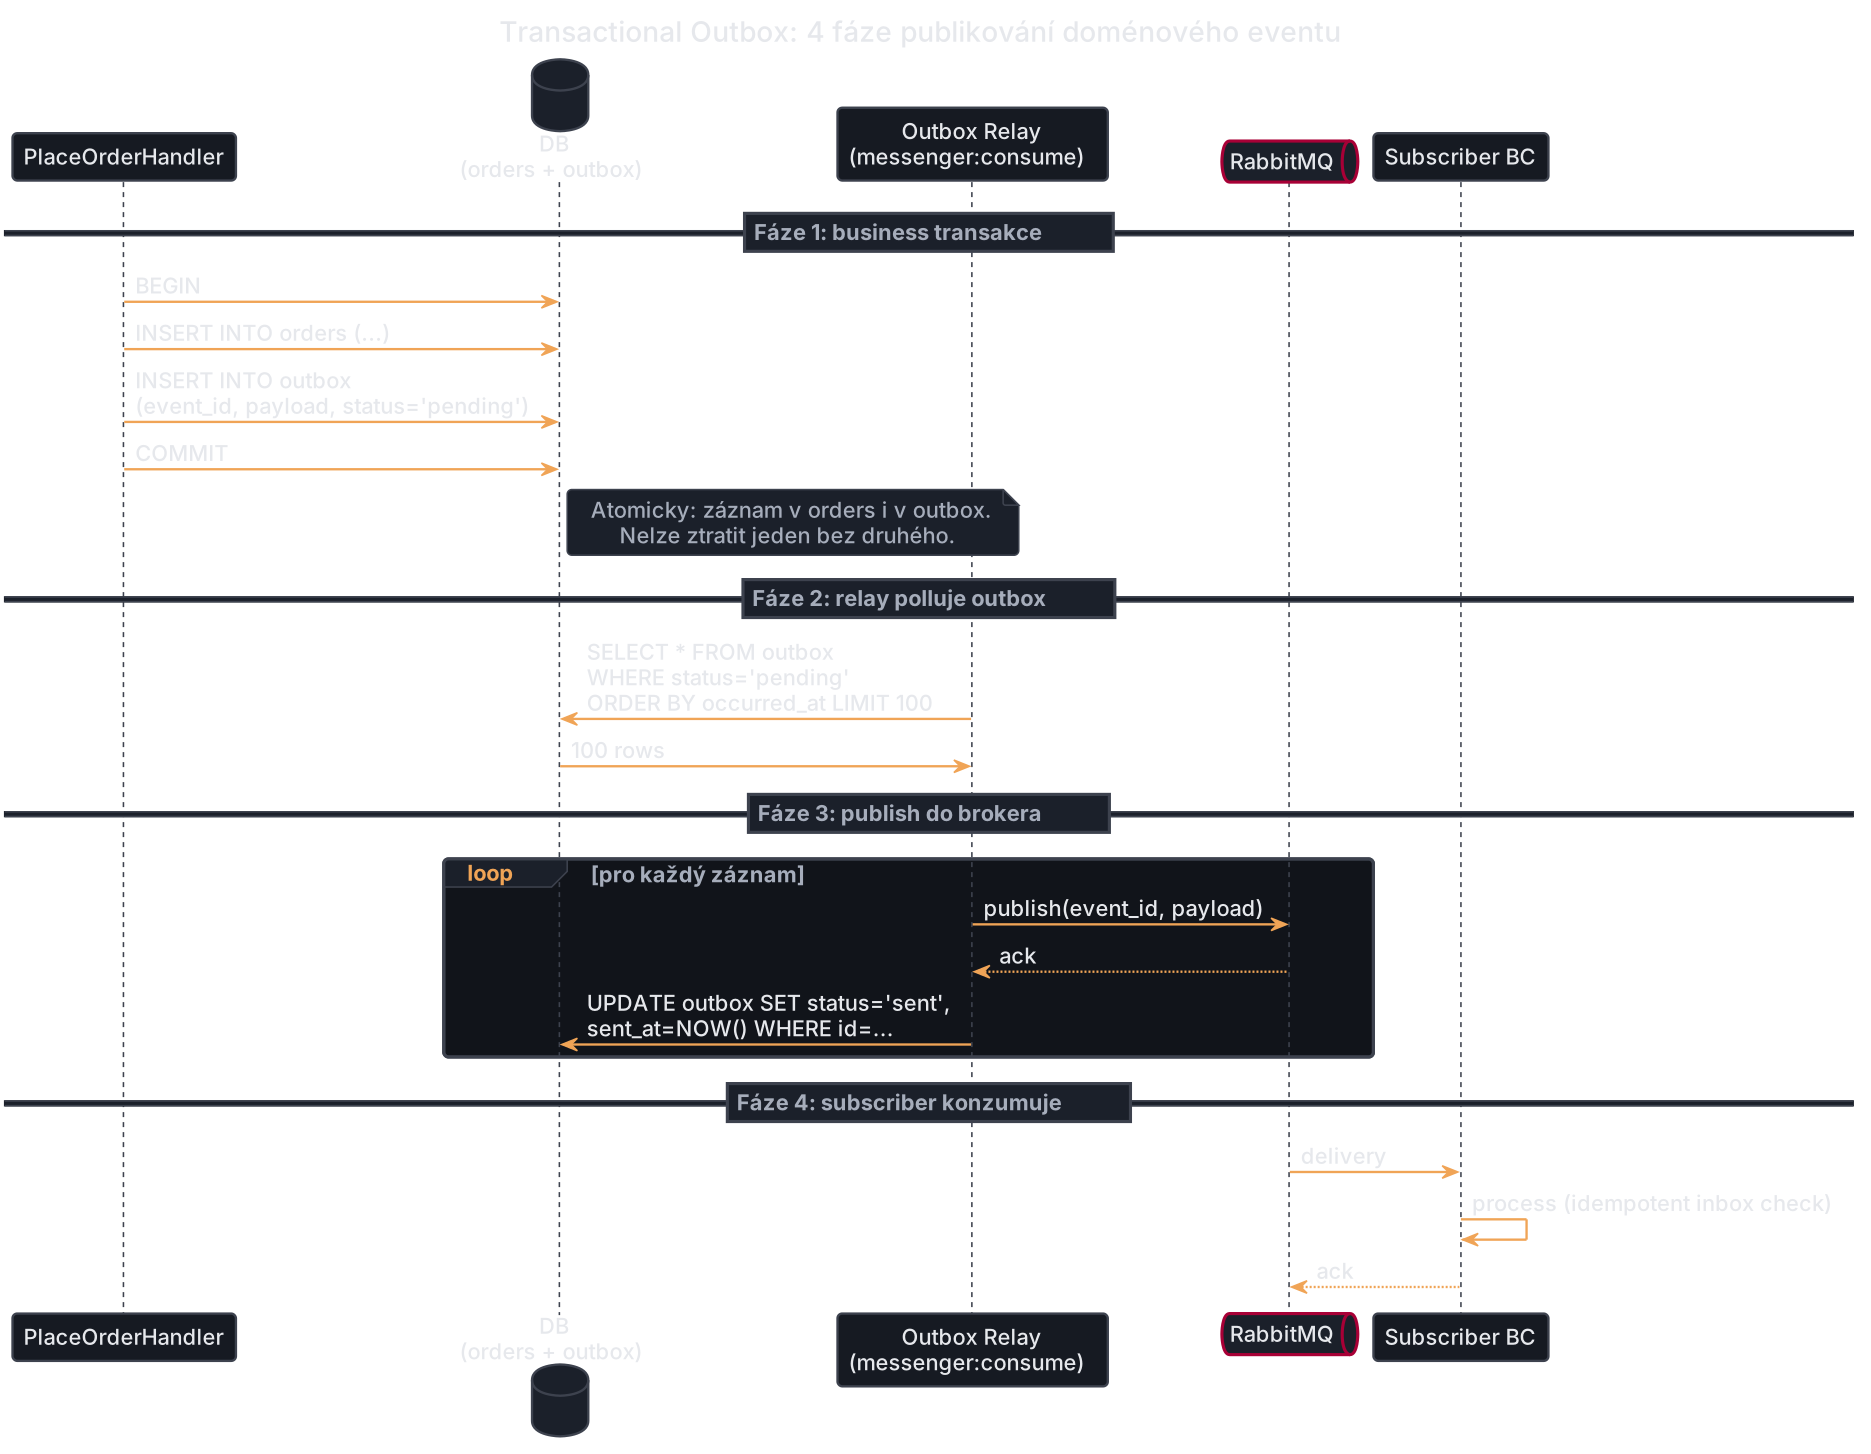
- Fáze 1 – doménová transakce. Application handler v jedné Doctrine transakci uloží agregát i odpovídající outbox řádky.
- Fáze 2 – polling outboxu. Relay worker periodicky (např. každých
100 ms) vybírá pending řádky z outboxu, seřazené podle
occurred_at. Výsledkem je best-effort FIFO, ne garantované pořadí. Proč, rozebírá sekce 15.05. - Fáze 3 – publish do brokeru. Pro každý řádek relay publikuje event
do brokera a po obdržení ACK řádek označí jako
sent. Obě operace neběží v jedné transakci. Spadne-li relay mezi nimi, řádek zůstanependinga po restartu se publikace zopakuje. Z toho plyne garance at-least-once delivery, rozebraná níže. - Fáze 4 – konzumace subscriberem. Subscriber zprávu přijme, zpracuje ji idempotentně (typicky přes Inbox Pattern) a potvrdí brokeru příjem (ACK).
15.03 Schéma outbox tabulky a Doctrine mapping#
Outbox tabulka má jedenáct sloupců. Každý řeší konkrétní provozní problém, který se bez něj projeví až pod produkční zátěží.
Entita níže nese Doctrine atributy a sedí v namespace App\Outbox\Domain. Jde
o pragmatickou zkratku. Outbox je infrastrukturní vzor; kdo drží přísné vrstvení
podle kapitoly Architektonické styly,
umístí tabulkovou entitu do Infrastructure.
Význam jednotlivých sloupců
| Sloupec | Typ | Účel |
|---|---|---|
id |
UUID v7 (16 B) | Primární klíč; UUID v7 roste s časem vzniku, relay ale řadí podle occurred_at. Deduplikaci nenese – tu zajišťuje eventId v payloadu události (viz Inbox). |
message_type |
VARCHAR(255) | FQCN integrační události (např. App\Ordering\Application\IntegrationEvent\OrderPlacedIntegrationEvent). Relay podle něj namapuje payload zpět na PHP třídu. |
aggregate_type |
VARCHAR(255) | Typ agregátu, který událost vydal (Order, Invoice). Debezium podle tohoto sloupce routuje do Kafka topiců, viz 15.05. |
aggregate_id |
VARCHAR(64) | ID konkrétní instance agregátu. Slouží jako klíč zprávy: události jednoho agregátu skončí ve stejné partition, a tím ve správném pořadí. |
payload |
JSON / JSONB | Serializovaný stav události. JSONB v Postgresu je preferovaný – umožňuje indexovat jednotlivá pole pro debugging. |
status |
VARCHAR(16) | Stavový enum: pending (čeká na publish), sent (úspěšně publikováno), failed (po N pokusech vzdáno, vyžaduje ruční řešení). |
occurred_at |
DATETIME | Čas vzniku události v doménové transakci. Slouží pro řazení v relayi (best-effort FIFO) a pro výpočet outbox lagu. |
attempts |
INT | Počet neúspěšných pokusů o publish. Po dosažení prahu (typicky 5) řádek přechází do failed a opouští hot path. |
sent_at |
DATETIME NULL | Vyplněno při přechodu do sent. Používá se pro kompakci (mazání starších sent řádků). |
last_error |
TEXT NULL | Poslední chyba publishe – důležité pro rozbor incidentu. |
available_at |
DATETIME | Čas, odkdy relay smí řádek znovu vzít. markFailed() ho posouvá exponenciálně, takže trvale selhávající zpráva nepálí pokusy v každém cyklu. |
Migrace cílí na MySQL/MariaDB. PostgreSQL varianta nahradí BINARY(16)
typem UUID a DATETIME typem TIMESTAMP(0) WITHOUT TIME ZONE; klauzule ENGINE
a CHARSET odpadají. TIMESTAMPTZ a JSONB by vyžadovaly jiné typy v mapování
(datetimetz_immutable, jsonb), jinak schema:validate hlásí rozpor. Na SQLite se BINARY(16) mapuje na BLOB
a JSON na CLOB. Takové ruční přepisování udělá doctrine:migrations:diff
spolehlivěji. Ukázka slouží k pochopení struktury, ne ke kopírování napříč
platformami. Pozor také na SQL komentáře uvnitř CREATE TABLE: introspekci
SQLite rozhodí a schéma se pak hlásí jako rozejité.
Po migraci spusťte php bin/console doctrine:migrations:migrate a ověřte,
že index existuje:
SHOW INDEXES FROM outbox WHERE Key_name = 'idx_outbox_status_time'
(MySQL) nebo
SELECT * FROM pg_indexes WHERE indexname = 'idx_outbox_status_time'
(PostgreSQL). Index se při refaktoringu schématu často ztratí, proto se vyplatí
regresní test v CI, který jeho existenci kontroluje.
15.04 Agregát publikuje, handler ukládá do outboxu#
Agregát nezná infrastrukturu: o RabbitMQ ani outbox tabulce neví nic. Vydává jen seznam doménových událostí, které z právě provedené operace plynou. Application handler ten seznam vezme a zařadí do outbox tabulky v téže transakci, ve které ukládá samotný agregát.
$this->em->wrapInTransaction(...) otevře transakci, vykoná callback, na konci
flushne a commitne. Když uvnitř callbacku vyletí výjimka, transakci rollbackne. Stejně
funguje Messenger middleware doctrine_transaction, který zabalí
celý handler do jedné transakce. Kanonický messenger.yaml z kapitoly o CQRS
ho na command.bus má, takže tam wrapInTransaction v handleru přebývá. Zůstane
z něj vnořený savepoint a nejasno, kde se vlastně commituje.
Ukázka ho drží, aby byl vzor čitelný i bez znalosti konfigurace
sběrnic; ve vlastním projektu patří transakce na jedno místo.
Doctrine adaptér je krátký, ale má dvě místa, která se často přehlédnou. store()
nesmí flushovat, protože transakci drží aplikační wrapper. fetchPending()
musí filtrovat i podle availableAt, jinak backoff z markFailed() nic neznamená.
1<?php2 3declare(strict_types=1);4 5namespace App\Outbox\Infrastructure;6 7use App\Outbox\Application\OutboxRepository;8use App\Outbox\Domain\OutboxMessage;9use Doctrine\ORM\EntityManagerInterface;10use Symfony\Component\Uid\Uuid;11 12final readonly class DoctrineOutboxRepository implements OutboxRepository13{14 public function __construct(private EntityManagerInterface $em) {}15 16 public function store(OutboxMessage $message): void17 {18 // Žádný flush. Zpráva musí odejít do DB ve stejné transakci19 // jako změna agregátu – o commit se stará volající.20 $this->em->persist($message);21 }22 23 public function fetchPending(int $limit = 100): array24 {25 return $this->em->createQuery(26 "SELECT m FROM " . OutboxMessage::class . " m27 WHERE m.status = 'pending' AND m.availableAt <= :now28 ORDER BY m.occurredAt ASC"29 )30 ->setParameter('now', new \DateTimeImmutable())31 ->setMaxResults($limit)32 ->getResult();33 }34 35 public function markSent(Uuid $id): void36 {37 $this->em->find(OutboxMessage::class, $id)?->markSent(new \DateTimeImmutable());38 $this->em->flush();39 }40 41 public function markFailed(Uuid $id, string $error): void42 {43 // Zde flush naopak patří: relay běží mimo doménovou transakci44 // a výsledek pokusu musí být vidět, i když další zpráva spadne.45 $this->em->find(OutboxMessage::class, $id)?->markFailed($error);46 $this->em->flush();47 }48}15.05 Relay process – dvě varianty#
Outbox tabulka sama nic nepublikuje. Potřebuje relay proces, který v určité kadenci vybírá pending řádky a posílá je do brokera. Katalog microservices.io pro to zná dva pojmenované vzory. Polling Publisher čte outbox tabulku dotazem a jeho jediná, zato podstatná přednost zní: funguje nad libovolnou SQL databází. Transaction Log Tailing místo dotazu čte transakční log databáze, tedy Postgres WAL nebo MySQL binlog. První vzor se realizuje jako Symfony Console command, druhý jako Debezium konektor nad Kafkou.
Varianta A: Polling Publisher (Symfony Console command)
Polling worker je obyčejný Symfony Console command, který ve vnitřní smyčce volá
fetchPending(), publikuje řádky a označí je jako sent.
Spouští se ze supervisord, systemd nebo Kubernetes
Deploymentu jako trvale běžící proces. Smyčka má časový limit; po jeho
vypršení se proces čistě ukončí a správce procesů ho spustí znovu.
Stejný vzor používá messenger:consume --time-limit; periodický restart
drží pod kontrolou paměť dlouho běžícího PHP procesu.
Zpětný převod obstará OutboxMessageFactory. Nejde o čistě mechanický opak
serializeru: denormalizace potřebuje znát cílovou třídu, a proto se opírá o whitelist.
Ten slouží i jako bezpečnostní opatření. Bez něj by o tom, jakou třídu aplikace vytvoří,
rozhodoval message_type z databáze:
1<?php2 3declare(strict_types=1);4 5namespace App\Outbox\Application;6 7use App\Ordering\Application\IntegrationEvent\OrderPlacedIntegrationEvent;8use App\Outbox\Domain\OutboxMessage;9use Symfony\Component\Serializer\Normalizer\DenormalizerInterface;10 11final readonly class OutboxMessageFactory12{13 /**14 * Whitelist typů, které smí relay vytvořit. Nový integrační event15 * znamená nový řádek zde – jinak skončí v dead-letter, ne v aplikaci.16 *17 * @var array<string, class-string>18 */19 private const ALLOWED = [20 OrderPlacedIntegrationEvent::class => OrderPlacedIntegrationEvent::class,21 ];22 23 public function __construct(24 private DenormalizerInterface $denormalizer,25 ) {}26 27 public function reconstitute(OutboxMessage $message): object28 {29 $class = self::ALLOWED[$message->messageType] ?? null;30 31 if ($class === null) {32 throw new \RuntimeException(33 sprintf('Unknown message_type "%s" in outbox.', $message->messageType),34 );35 }36 37 return $this->denormalizer->denormalize($message->payload, $class, 'json');38 }39}Integrační událost se denormalizuje bez potíží právě proto, že nese samé primitivy.
Doménová událost s hodnotovými objekty by tu skončila hláškou
„Cannot create an instance of OrderId from serialized data because its constructor
requires the following parameters to be present: $value“. I proto se přes hranici
posílá integrační tvar.
Varianta B: CDC / Debezium
Change Data Capture (CDC) je kanonicky Transaction Log Tailing: místo
aplikačního polleru čte Postgres WAL (Write-Ahead Log) nebo MySQL binlog
a streamuje každý INSERT do outbox tabulky přímo do Kafky. Standardním nástrojem
je Debezium, plugin pro Kafka Connect, který
funguje jako logický replikační odběratel databáze.
Aplikace zapíše řádek do outbox, Debezium ten INSERT uvidí
v transakčním logu, vytvoří Kafka record a pošle ho do odpovídajícího topicu.
Řádek se pak už nemění, tabulka funguje jako append-only log.
| Aspekt | Polling Publisher (A) | Transaction Log Tailing / Debezium (B) |
|---|---|---|
| Latence | 50–500 ms (polling interval) | jednotky až desítky ms (push z WAL) |
| Operační složitost | 1× console command + supervisor | Kafka + Kafka Connect + Debezium konektor + monitoring 4 procesů |
| Volba brokera | Libovolný (RabbitMQ, SQS, Redis, Doctrine async) | Pouze Kafka (resp. Pulsar, Kinesis přes adaptér) |
| Scale-out | stovky až nízké tisíce zpráv/s na worker, lineárně s replikami přes SKIP LOCKED | dáno Kafkou, o dva řády výš |
| Garance pořadí | Best-effort podle occurred_at |
Per-partition podle aggregate_id |
| Provozní riziko | Zaseknutý worker = rostoucí lag | Zaseknutý konektor drží replikační slot a WAL se hromadí na disku primární databáze |
| Doporučeno pro | Běžný Symfony projekt | Multi-tenant SaaS, finanční systémy, IoT |
Kniha dál pracuje s variantou A. Typickému Symfony projektu dá dostatečnou spolehlivost bez Kafka stacku, který by jinak přibyl jen kvůli outboxu. Debezium se vyplatí teprve tehdy, když už v produkci běží zhruba pět Kafka konzumentů a outbox lag začíná být úzkým hrdlem.
Konfiguračně jde o Kafka Connect konektor (REST API, nebo deklarativně přes
Strimzi operator). Jádrem je transformace Outbox Event Router
(io.debezium.transforms.outbox.EventRouter). Ta má vlastní představu
o schématu tabulky, kterou je dobré znát dřív, než se konektor nasadí:
- Routuje podle sloupce
aggregatetype, ne podle typu události. Výchozí topic jeoutbox.event.<hodnota aggregatetype>, pro hodnotuOrdertedyoutbox.event.Order, nikoli topic pojmenovaný po tříděOrderPlaced. - Klíčem Kafka zprávy je
aggregateid. Právě odtud plyne pořadí uvnitř partition. - Sloupec
idcestuje jako hlavička zprávy a dokumentace ho nabízí přímo k deduplikaci na straně konzumenta. - SMT automaticky odfiltruje
DELETEoperace nad outbox tabulkou. Kanonický Debezium model proto řádek vloží a hned smaže; sloupecstatusv něm vůbec nefiguruje.
Aplikační strana tedy beze změny nezůstane. Schéma z 15.03
má sloupce aggregate_type a aggregate_id s podtržítkem a navíc stavový model.
Přechod na variantu B proto znamená buď přejmenovat sloupce podle výchozího
očekávání SMT, nebo přemapovat volby route.by.field a table.field.event.*.
Rozhodnutí čeká i stavový sloupec: buď status zůstane kvůli auditní stopě
a konektor ho bude ignorovat, nebo tabulka přejde na insert-and-delete
model, který nepotřebuje kompakci.
Pro Postgres k tomu přibude logická replikace. Výchozí plugin.name konektoru
je decoderbufs, který vyžaduje serverové rozšíření; pgoutput je v Postgresu
od verze 10 nativní, a proto v praxi častější. Logická replikace vyžaduje wal_level = logical
a pro uživatele konektoru privilegium CREATE kvůli vytvoření publikace.
Citace: Debezium dokumentace – Outbox Event Router (Red Hat, 2019+).
Doctrine transport jako outbox bez vlastní tabulky
Symfony Messenger nabízí třetí cestu bez vlastní outbox tabulky
i bez relay commandu. Transport doctrine://default ukládá zprávy do tabulky
messenger_messages ve stejné databázi, kde žije doménový stav. Atomicitu
zajišťuje middleware doctrine_transaction na command busu: transakce,
kterou middleware otevře kolem command handleru, obalí uložení agregátu
i dispatch události na doctrine transport. Podmínkou je, že transport používá
totéž DB spojení jako doménový stav, tedy default entity manager. Dual-write
problém tím mizí: buď se commitne objednávka i zpráva, nebo nic. Worker
messenger:consume async_events pak zprávu vyzvedne a zpracuje. Do externího brokera
ji sám nepřepošle; na to je potřeba vlastní handler nebo relay z předchozích sekcí.
V této variantě PlaceOrderHandler integrační událost do outboxu neukládá. Rovnou ji
dispatchne a routing ji pošle na doctrine transport:
1// Místo $this->outbox->store(OutboxMessage::fromIntegrationEvent(...)):2$this->eventBus->dispatch($integrationEvent);Symfony dokumentace tuto konfiguraci nikde nenazývá outboxem; slovo v ní nepadne.
Atomicita ale reálně platí. DoctrineTransactionMiddleware otevře transakci nad
spojením entity manageru, spustí handler, pak flushne a commitne. Connection::send()
doctrine transportu je prostý INSERT nad týmž spojením a vlastní izolovanou
transakci neotevírá. Zápis zprávy i flush agregátu proto commitnou společně.
Daň za pohodlí je trojí. Formát uložené zprávy je svázaný s Messengerem: payload
serializuje envelope i se stampy, takže ho mimo Symfony nikdo rozumně nepřečte.
Auditovatelnost a retence jsou horší než u vlastní outbox tabulky: zpracované
řádky worker maže, žádný stav sent, žádné last_error, žádná historie pro
rozbor incidentu. A schéma tabulky určuje Messenger; migrace ho jen
přebírá.
Pro menší systémy je to přesto nejjednodušší správná volba: dual-write je vyřešený, kód se omezí na konfiguraci a jeden worker. Vlastní outbox tabulka se vyplatí až tam, kde je potřeba auditní stopa, řízená retence nebo publish do brokera mimo Messenger.
Pořadí zpráv: best-effort, ne garance
ORDER BY occurred_at sugeruje víc, než dokáže splnit. Katalog microservices.io
u Polling Publisheru uvádí drawback „tricky to publish events in order“ a v této
implementaci se sejdou hned tři důvody. Hodnota occurred_at vzniká v PHP procesu,
takže mezi instancemi podléhá odchylce hodin. Při shodné hodnotě není pořadí
definované vůbec. Se sekundovou přesností sloupce (viz komentář
v migraci) přitom shody nejsou výjimkou. A relay publikuje
řádek po řádku, takže selhání uprostřed batche pustí pozdější událost před dřívější.
Spolehlivé pořadí lze držet jen per agregát a jen tehdy, když ho nese klíč zprávy.
Proto je ve schématu aggregate_id. V Kafce z něj plyne partition, uvnitř které
je pořadí garantované. Globální pořadí napříč agregáty neexistuje a doménová
logika na něm stavět nesmí.
Filtru status = 'pending' se naopak netýká gap problém, který popisuje kapitola
Event Sourcing. Ten trápí relay,
který si drží checkpoint na auto-increment ID: transakce s nižším ID může commitnout
později a relay ji za posunutým checkpointem už nepřečte. Outbox tabulka se stavovým
sloupcem checkpoint nemá. Řádek je viditelný teprve po commitu a zůstane pending,
dokud ho relay nepublikuje. Opožděný commit se objeví v některém dalším cyklu.
15.06 Idempotent Inbox – strana subscribera#
Outbox dává at-least-once delivery, takže subscriber musí počítat s tím,
že stejnou událost dostane víckrát. Když je vedlejší efekt handleru neidempotentní (typicky
UPDATE counter SET value = value + 1), duplicita se okamžitě projeví jako
chybný stav read modelu. Zákazník vidí 200 Kč na účtu místo 100 Kč, počet
objednávek je dvojnásobný, e-mail dorazí dvakrát.
Řešení má v katalozích dvě jména. microservices.io vede vzor jako Idempotent
Consumer a doporučuje tabulku zpracovaných zpráv s kompozitním klíčem
(subscriberId, messageID). Starší je Idempotent Receiver z Enterprise
Integration Patterns (Hohpe & Woolf, 2003): příjemce navržený tak, aby tutéž
zprávu snesl vícekrát. Kapitola se drží pracovního jména Idempotent Inbox.
Realizace je zrcadlem outboxu: tabulka inbox v databázi subscribera
s kompozitním UNIQUE constraintem na dvojici (event_id, consumer). Před
zpracováním události handler zkontroluje, zda je daná dvojice už v inboxu. Pokud ano,
ackne brokerovi a skončí. Pokud ne, provede svou logiku a v téže transakci
vloží nový řádek do inboxu. UNIQUE constraint slouží jako pojistka proti
race condition.
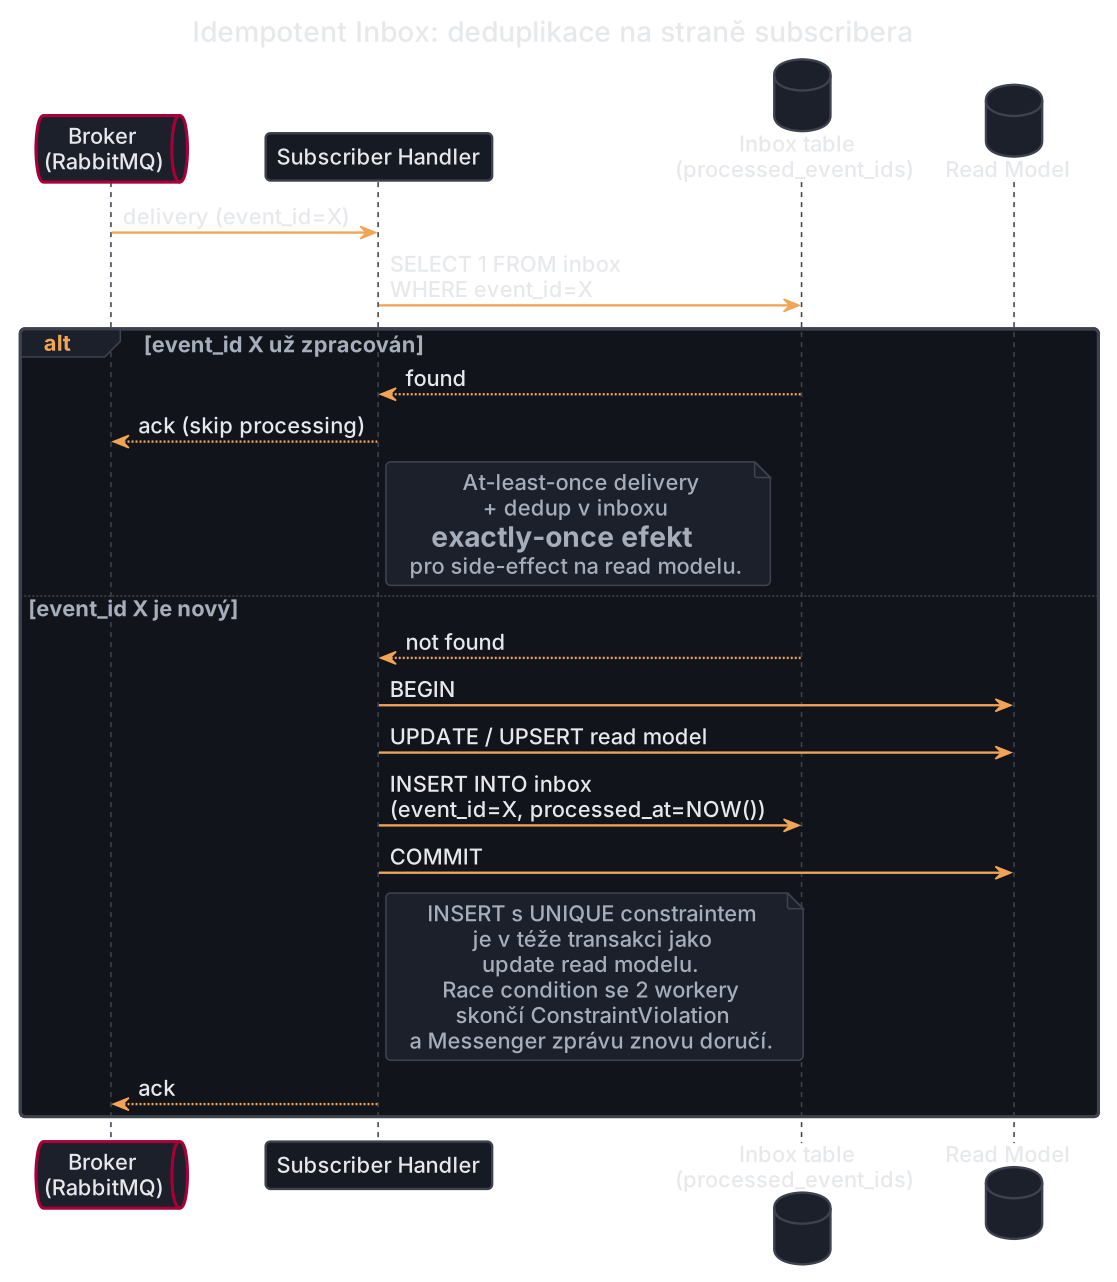
Sloupec consumer má v inbox tabulce svůj důvod. Tentýž event_id
zpracovává víc subscriberů (Reporting, Notifications, Search index) a každý
si potřebuje vést vlastní stav „už zpracováno“. Bez sloupce
consumer by druhý subscriber narazil na UNIQUE constraint prvního a událost by
nikdy nezpracoval. UNIQUE je proto kompozitní (event_id, consumer),
ne jen event_id.
Retence inbox tabulky
Inbox roste stejně jako outbox, jen se na to častěji zapomíná. Každá zpracovaná zpráva v něm nechá řádek a nic ho nemaže. Po roce provozu se z pojistky proti duplicitám může stát největší tabulka v databázi subscribera.
Horní hranici retence určuje doba, po kterou může broker zprávu ještě doručit: maximální TTL zprávy plus nejdelší retry okno relay procesu. Řádek starší než tento součet už nemá co deduplikovat. Obvykle se drží 30 dní – bezpečně nad běžným nastavením obou lhůt. Maže se stejným batch cronem jako outbox. Kdo retenci zvolí kratší než reálné retry okno, otevře si díru: opožděná zpráva projde jako nová.
15.07 Provozní aspekty#
Ve vývojovém prostředí outbox funguje bez údržby. Produkce přinese čtyři provozní otázky: jak měřit lag, jak držet tabulku malou, co s trvale selhávajícími řádky a jak monitorovat, že se na něco nezapomnělo.
Outbox lag
Outbox lag je doba, kterou událost stráví ve stavu pending, než ji relay
pošle do brokera. Jako alarmová metrika slouží stáří nejstaršího pending řádku.
Tyto metriky exportujte do Promethea (outbox_pending_seconds,
outbox_pending_count) a v Grafaně nad nimi postavte alert. Kritický
práh bývá 30 sekund. Když ho lag překročí, něco se zaseklo:
relay worker padl, broker je nedostupný, DB má 100% CPU. Při normálním provozu
je medián lagu pod 1 sekundou.
Kompakce outbox tabulky
Outbox tabulka roste lineárně s počtem publikovaných událostí. Bez kompakce po roce
provozu obsahuje miliony historických řádků. Ty zpomalují i indexované dotazy
a zbytečně zabírají disk. Standardní strategie maže řádky ve stavu sent
starší než N dní, kde N je obvykle 7 až 30 podle compliance požadavků.
LIMIT 10000 je zde záměrně: mazání jde po dávkách, ne jediným DELETE FROM outbox. Velký delete běží jako jedna dlouhá transakce, drží zámky na obrovském
počtu řádků a může blokovat produkční INSERTy z handlerů. Cron ho spouští každých
5 minut a 10 000 řádků za běh stačí na běžnou zátěž (zhruba 3 mil. událostí denně).
Nabízející se zápis DELETE … WHERE sent_at < NOW() - INTERVAL 30 DAY LIMIT 10000
je kratší, ale funguje jen v MySQL a MariaDB. Postgres i SQLite ho odmítnou,
a protože cron běží potichu, chyba se projeví až rostoucí tabulkou. Hranice
se proto počítá v PHP a batch se vymezuje poddotazem nad id.
Dead-letter queue pro permanentní selhání
Některé události se nepublikují nikdy. Třída integrační události se změnila a starý
payload už nejde denormalizovat, message_type chybí ve whitelistu
OutboxMessageFactory nebo je payload poškozený. Po N pokusech (typicky 5)
je OutboxMessage::markFailed() přepne do stavu failed. S takovými řádky se
zachází takto:
- Vyčlenit z hot pathy – relay je už nezkouší publikovat.
- Hlasitě upozornit – alert
outbox_failed_total > 0. - Mít na ně CLI nástroj –
app:outbox:retry-failednebo ruční SQL update statusu zpět napendingpo opravě příčiny. - Nikdy nemazat automaticky. Řádek ve stavu
faileddokládá nedoručenou událost a má zůstat evidovaný i po týdnech.
Vacuum a index bloat (PostgreSQL)
Outbox má specifický I/O profil: vysoký INSERT rate, krátký životní cyklus (řádek vznikne →
během sekund se UPDATE na sent → po N dnech DELETE), historie se nikdy nečte.
Výchozí nastavení autovacuum v PostgreSQL na takový profil není dimenzované
a po několika dnech provozu se objeví index bloat:
- UPDATE statusu vytvoří novou verzi řádku a stará zůstane jako mrtvá (MVCC).
Mění se indexovaný sloupec
status, takže HOT update nepřipadá v úvahu a nová verze dostane i nové položky v indexech. - DELETE při kompakci přidá další mrtvé řádky.
- Výchozí práh autovacuum (
autovacuum_vacuum_scale_factor = 0.2) čeká, než se nasbírá 20 % mrtvých řádků. Při tisících zápisů za sekundu to trvá minuty. - Mezitím index
(status, occurred_at)nabobtná na násobky původní velikosti, selecty se zpomalují a lag stoupá.
Standardní opatření: per-table vacuum tuning.
Partitioning při vysokém objemu (PostgreSQL)
Při trvale vysokém objemu, tedy v řádu tisíců událostí za sekundu, se single-table
outbox stává provozním úzkým hrdlem. PostgreSQL declarative partitioning podle
occurred_at přináší:
- Rychlé mazání starých dat přes
DETACH PARTITIONaDROP TABLEmístoDELETE. Odpadá dlouhá mazací transakce a doba nezávisí na počtu řádků (O(1) místo O(n)). BěžnýDETACHpotřebuje exkluzivní zámek rodičovské tabulky;DETACH PARTITION … CONCURRENTLY(od PostgreSQL 14) vystačí se slabším. - Cílené vacuum – autovacuum pracuje per-partition, takže staré partice, do kterých se už nezapisuje, ho téměř nezaměstnávají.
- Lokalitu indexu – aktivní partition obsahuje jen události posledních hodin, index je malý a vejde se do RAM.
Provozní automatizace: rozšíření pg_partman
spravuje vznik nových partitions i mazání starých přes cron. Pro MySQL existuje
nativní PARTITION BY RANGE se stejným efektem, ale bez obdoby pg_partman –
správa je ruční.
Distributed relay – multi-instance
Singleton polling worker (replicas: 1 v Kubernetes) je nejjednodušší
konfigurace. Má ale dvě slabiny. První je single point of failure: worker
spadne nebo zamrzne a lag roste, dokud ho Kubernetes nerestartuje. Druhá je
omezená propustnost, protože jeden PHP proces odbaví řádově stovky až nízké
tisíce zpráv za sekundu.
Při vyšším objemu nebo přísnějším požadavku na dostupnost se nabízejí dvě cesty:
Cesta 1 – leader election přes Redis/etcd. Běží víc workerů, ale publikuje jen jeden, „leader“. Když leader spadne, převezme jeho roli jiný nejpozději po vypršení lease (v ukázce 10 s). Výsledkem je HA bez double publish, propustnost se ale nezvýší – dispatchuje pořád jen jeden worker.
Worker volá acquireOrRenew() každé 3 sekundy (TTL 10 s dává rezervu pro síťové
zpoždění). Dokud metoda vrací false, worker stojí. Jakmile při některém tiku
vrátí true, stal se leaderem a začne dispatchovat. Pozor: zpracování batche musí
doběhnout dřív, než lease vyprší, nebo si ho worker musí během batche průběžně
obnovovat. Jinak lease převezme nový leader, začne dispatchovat řádky, které starý
worker ještě publikuje, a vznikne double publish.
Cesta 2 – SELECT … FOR UPDATE SKIP LOCKED. Více workerů běží paralelně a každý
si zarezervuje vlastní batch řádků. Leader ani single point of failure zde nejsou.
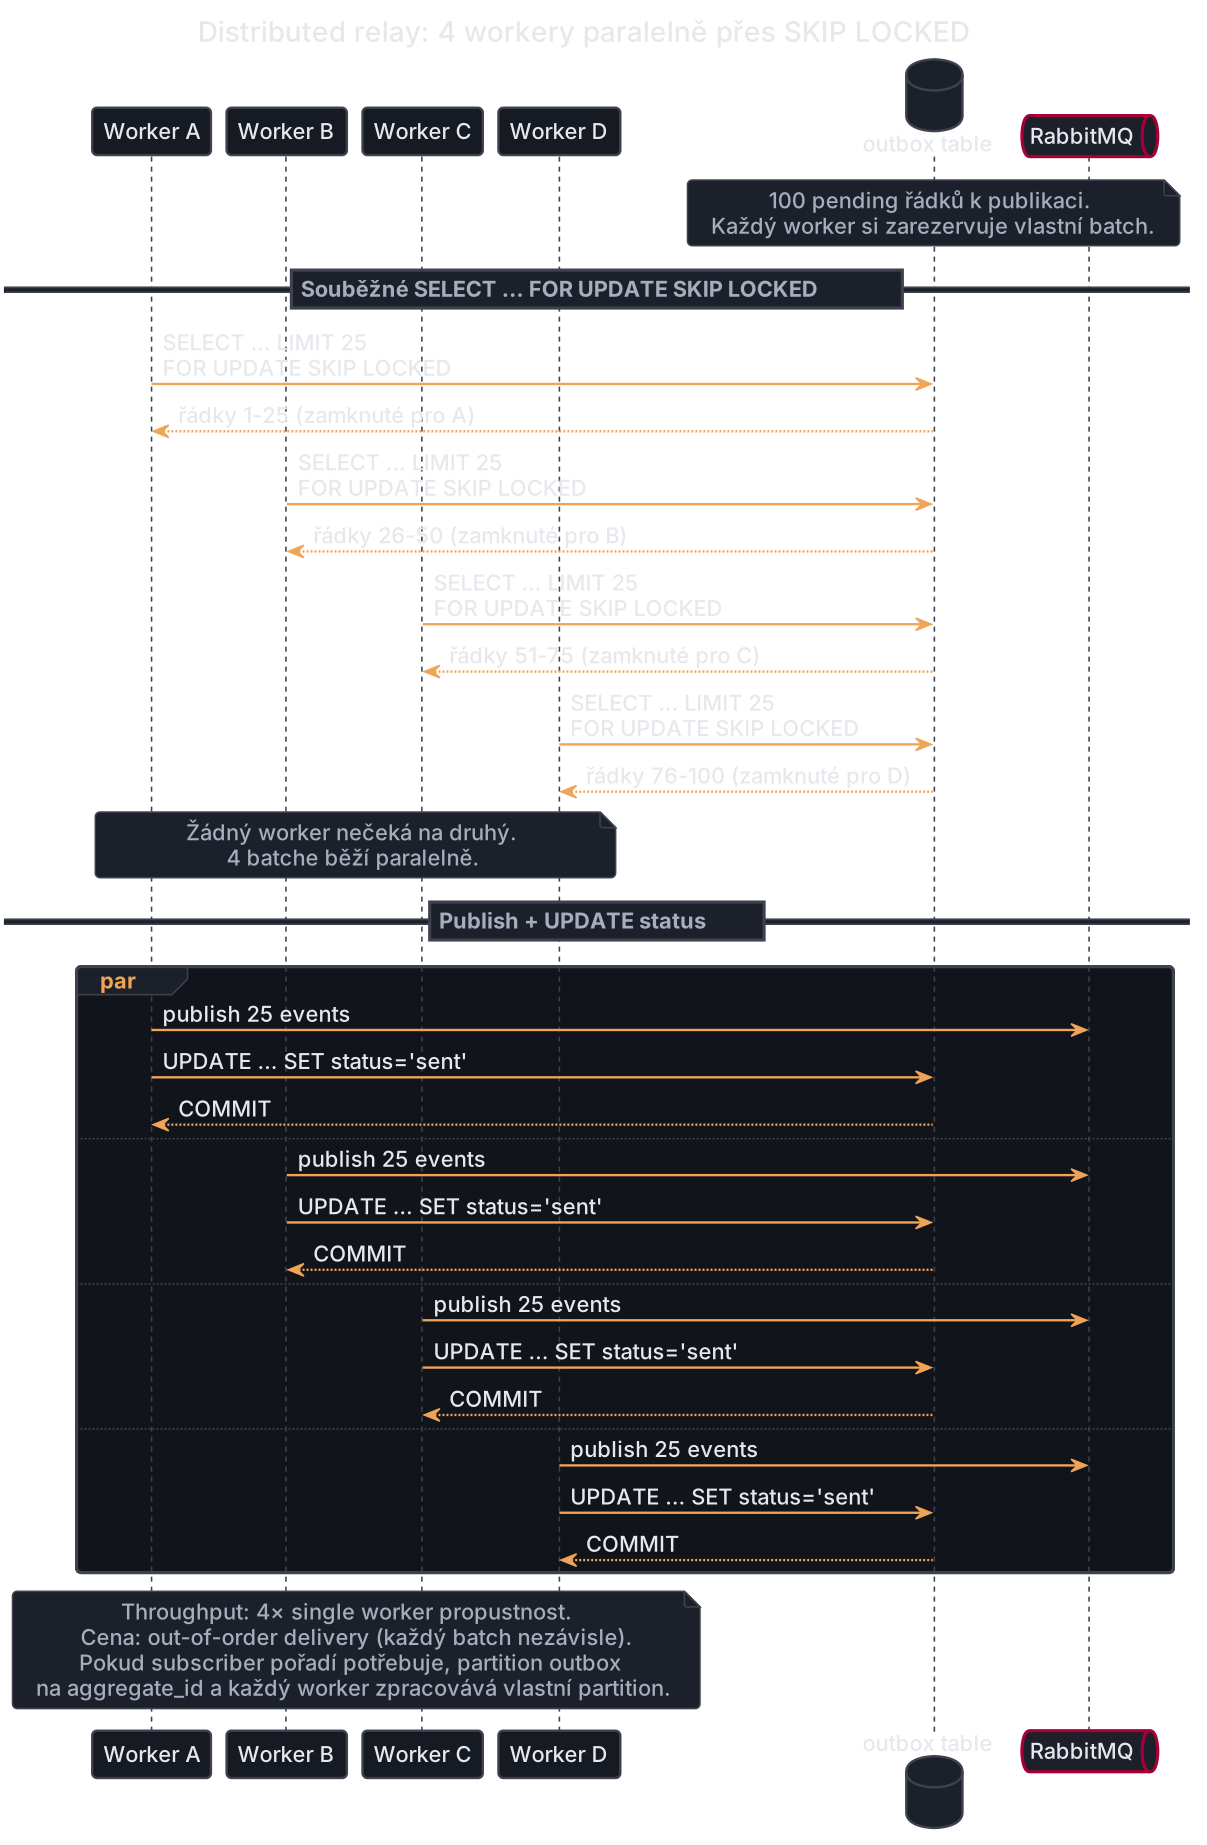
Propustnost pak roste zhruba lineárně s počtem workerů a at-least-once garance
zůstává zachovaná. SKIP LOCKED podporuje PostgreSQL od verze 9.5 i MySQL 8.
Cenou je pořadí: události téhož agregátu mohou vyjít mimo pořadí, když je
zpracovávají různé workery v různých batchích. Záleží-li subscriberovi na pořadí,
rozdělí se outbox podle aggregate_id (například hash modulo počet workerů)
a každý worker zpracovává jen svou část.
Backpressure – co když broker nestíhá
Když Kafka nebo RabbitMQ nestíhá přijímat (síťová chyba, plný disk brokera, volba
partition leadera), relay dostává na publish timeout nebo chybu. Outbox řádky
zůstávají pending a kupí se. Produkční INSERTy se přitom nebrzdí: kdo začne
blokovat aplikační vrstvu, šíří výpadek brokera do core domény.
Výpadek brokera je jiný druh chyby než nepublikovatelná zpráva ze sekce
o dead-letter queue. markFailed() z 15.03 by při půlhodinovém
výpadku vyčerpal pět pokusů zhruba za půl minuty a přesunul do failed i zdravé
řádky. Chybu spojení s brokerem (TransportException) proto
relay do attempts nezapočítává: přeruší
cyklus a čeká s backoffem na úrovni celého workeru.
Standardní vzor má čtyři složky. Worker po neúspěšném publishi přechází na
exponential backoff a čeká 1 s, 2 s, 4 s, maximálně 30 s. Mezitím loguje
outbox_publish_errors_total. Alert hlídá rychlost růstu pending:
delta(outbox_pending_count[5m]) > 10000 signalizuje, že zápis převyšuje
odběr a broker nestíhá. Kapacitně musí databáze absorbovat 30 minut
výpadku brokera; při 1 000 událostech za sekundu to je 1,8 mil. řádků navíc,
tedy rozpočet na disk a vacuum. U událostí s nízkou prioritou (audit, metriky),
které ztrátu snesou, lze při dlouhodobém backpressure zvážit řízený sampling.
Integrační události s byznysovým faktem (OrderPlacedIntegrationEvent) ale zahodit nelze.
15.08 Anti-vzory#
Outbox má jednoduché schéma, přesto se v code review opakují stále tytéž chyby. Ruší jeho garance a vracejí systém k dual-write problému.
15.09 Migrace existujícího projektu – krok za krokem#
Osmnáct měsíců starý Symfony projekt se stovkou handlerů a publishem po flushi se na outbox nepřevádí big-bang refaktorem. Outbox přibývá handler po handleru, vedle stávajícího chování, a starý kód mizí teprve tehdy, když nový prokazatelně funguje.
Krok 1: Přidat outbox tabulku a entitu
Vytvořte migraci podle sekce 15.03, spusťte
doctrine:migrations:migrate, nasaďte do produkce. Tabulku zatím
nikdo nepoužívá, riziko regrese je nulové. Ověřte, že migrace skutečně
vytvořila kompozitní index idx_outbox_status_time, ne jen jednosloupcový.
Krok 2: Refactor jednoho handleru
Vyberte jeden hlavní handler – typicky PlaceOrderHandler nebo cokoli,
kde dual-write nejvíc bolí. Přidejte do něj wrapInTransaction a vedle
$bus->dispatch() volejte $outbox->store(OutboxMessage::fromIntegrationEvent(...))
s integračním tvarem události (viz 15.04).
Staré $bus->dispatch() zatím nemažte – legacy subscribeři by přestali fungovat.
Posílejte jím ale tutéž instanci integrační události, kterou handler ukládá do
outboxu. Shodné eventId obou kopií potřebuje Inbox v kroku 4. Subscribery, kteří
dosud poslouchali doménovou událost, je proto potřeba ve stejném kroku přepnout
na integrační tvar.
Krok 3: Přidat inbox subscriberům jeden po druhém
Pro každý subscriber kontextu vytvořte inbox tabulku, refaktorujte handler
podle sekce 15.06. Jde o nejdelší krok migrace (typicky týdny),
ale paralelizovatelný mezi týmy – každý kontext si Inbox přidává nezávisle.
Inbox musí stát dřív než relay. Jinak by subscribeři mezi nasazením relaye
a vlastního Inboxu dostávali každou událost dvakrát a dvakrát ji zpracovali.
Krok 4: Nasadit relay command
Až mají Inbox všichni subscribeři událostí z refaktorovaného handleru,
implementujte OutboxDispatchCommand ze sekce 15.05 a nasaďte ho
pod supervisorem. Dokud je aktivní i legacy publish, dostanou subscribeři obě verze
každé události a Inbox druhou kopii zahodí. Podmínkou je, že legacy dispatch
z kroku 2 posílá integrační událost se stejným eventId jako řádek v outboxu.
Doménová událost eventId nemá a Inbox by obě kopie nespároval.
Krok 5: Vypnout legacy publish
Až relay běží stabilně, smažte v handleru původní $bus->dispatch();
doručení událostí pak zůstává jen na outboxu. Jde o riskantní krok – během
prvních dnů sledujte outbox lag a počet duplicit zachycených inboxem. Když něco selhává,
revert pull requestu vrátí změnu během pěti minut.
Krok 6: Měřit a ladit
Po měsíci provozu projděte metriky: jaký je medián lagu, jakým tempem roste tabulka,
kolik řádků skončilo ve failed, kolik duplicit Inbox odchytil. Podle těchto
čísel se ladí polling interval relay procesu, batch limit, retence cleanupu
a prahy alertů. Outbox není „set-and-forget“ – vyžaduje občasnou provozní údržbu.
15.10 Shrnutí#
Outbox Pattern stojí na tabulce navíc, jednom Symfony commandu a úpravě jednoho application handleru. Výměnou vyřadí celou třídu chyb (ztracené události, phantom eventy), které by se jinak dohledávaly v logech až po incidentu. Výsledná garance je at-least-once delivery událostí přes libovolný message broker, bez XA/2PC a bez speciální cloudové služby.
Idempotent Inbox je nutný protějšek na straně subscribera. Bez něj se duplikace z outboxu propíše do read modelů a vedlejších efektů a zisk z outboxu se ztratí. Outbox s Inboxem dávají exactly-once efekt: každá událost se v read modelu projeví právě jednou, i když broker dodá zprávu vícekrát.
Srovnání s alternativami
Outbox není jediná odpověď na dual-write. Ostatní cesty mají užší záběr nebo vyšší cenu.
| Řešení | Jak řeší dual-write | Kdy se hodí |
|---|---|---|
| Transactional Outbox | Zápis události do téže DB transakce, publikuje relay | Výchozí volba všude, kde agregát žije v ACID databázi |
| Event Sourcing | Událost je stav, druhý zápis neexistuje | Když se pro doménu vyplatí i zbytek modelu, ne jen kvůli doručení |
| Listen-to-yourself | Aplikace nejdřív publikuje, DB zapíše až konzument vlastní zprávy | Když je broker spolehlivější než vlastní DB a čtení smí být opožděné |
| Synchronní volání | Dual-write nevzniká, kontexty se volají přímo | Malý systém bez asynchronní integrace; platí se autonomií kontextů |
| 2PC / XA | Distribuovaná transakce nad DB i brokerem | Prakticky nikdy – viz 15.01 |
Kombinace se nevylučují. Event-sourcovaný kontext outbox tabulku nepotřebuje, protože event store ji zastane, ale Inbox na straně konzumenta potřebuje pořád.
Hlavní body pro praxi:
- Outbox je tabulka v téže DB jako doménový stav – jinak ztrácí smysl.
- Doctrine entita potřebuje
#[ORM\Index(columns: ['status', 'occurred_at'])], bez něj relay dělá full table scan při každém pollingu. - Atomicitu objednávky a outbox řádků garantuje jedna transakce: middleware
doctrine_transaction, nebo$em->wrapInTransaction(...)v handleru. - Polling Publisher pod supervisorem stačí pro téměř každý Symfony projekt; Transaction Log Tailing přes Debezium pouze pro Kafka-native systémy s vysokým objemem, a i tam za cenu jiného schématu tabulky.
- Inbox tabulka má UNIQUE
(event_id, consumer)– sloupec consumer je klíč pro multi-subscriber scénáře. - Monitoring outbox lagu, počtu odeslaných a selhaných zpráv a inbox duplicit je nezbytný.
- Migrace existujícího projektu je inkrementální – handler po handleru, kontext po kontextu, nikdy big-bang.
Outbox Pattern navazuje na vzory z předchozích kapitol. V CQRS zajišťuje spolehlivé doručení událostí z command side do read side. V Event Sourcingu roli outboxu přebírá event store a relay nahrazují projekce, které ho čtou. V ságách garantuje doručení událostí i příkazů mezi kontexty, takže sága se nikdy „nezasekne“ kvůli ztracené zprávě.
Doporučená literatura k prohloubení: Helland, P. – Life Beyond Distributed Transactions, CIDR (2007); Richardson, C. – Microservices Patterns, Manning (2018), kap. 3 a 4; Kleppmann, M. – Designing Data-Intensive Applications, O'Reilly (2017), kap. 11 (Stream Processing); microservices.io – Pattern: Transactional Outbox.
Časté otázky
Outbox vs. CDC / Debezium – co kdy?
Pro běžný Symfony projekt stačí Polling Publisher (varianta A). Provozní režie je minimální (jeden Symfony command pod supervisorem) a latence pod 1 sekundou stačí pro typické obchodní scénáře (objednávky, platby, notifikace). Debezium / CDC se vyplatí až tam, kde je (a) Kafková infrastruktura už nasazená, (b) latenční požadavek pod 50 ms, (c) objem nad 10 000 událostí/s, (d) tým se zkušeností s Kafka Connect. Jinak se platí několikanásobná provozní složitost za malý přínos. Detail v sekci 15.05.
Co když používáme NoSQL databázi (MongoDB, Cassandra, DynamoDB)?
Žije-li agregát v NoSQL úložišti bez ACID transakcí přes více dokumentů (Cassandra, raná verze MongoDB), klasický Outbox Pattern nefunguje: atomicita zápisu objednávky a události do dvou kolekcí není zaručená. Možnosti: (1) MongoDB od verze 4.0 má transakce přes více dokumentů, takže outbox jde, (2) DynamoDB nabízí TransactWriteItems – totéž, (3) Cassandra ACID transakce nemá (logged batch zaručí jen, že se nakonec provedou všechny zápisy, bez izolace) – používá se Change Data Capture nebo event sourcing s událostmi uloženými přímo v dokumentu agregátu. Volba úložiště pro doménový stav rozhoduje, zda lze Outbox vůbec implementovat.
Jak velký dělat batch v relayi?
Standardně 100 řádků za polling cyklus. Interval 100 ms platí jen pro prázdný outbox: dokud jsou pending řádky, relay jede bez pauzy a propustnost určí latence brokera a databáze. Pokud lag stoupá nad 5 sekund a CPU brokera má rezervu, zvyšte limit na 500. U batche nad 1 000 narazíte na DB serializaci updateů – místo jednoho velkého batche práci rozdělte na víc workerů se SELECT ... FOR UPDATE SKIP LOCKED. Hlavní pravidlo: nejdřív měřit, pak ladit, ne „na cit“.
Vyplatí se Outbox v monolitu?
Ano. Dual-write problem nevzniká až mezi microservices, ale mezi libovolnými dvěma transakčními systémy. Monolit publikující události do RabbitMQ nebo Redis Streams má přesně stejný problém jako microservice: transakce databáze je oddělená od potvrzení brokera. Má-li monolit event-driven kontexty (Symfony Messenger s async transportem, Spatie Laravel events apod.), outbox se v něm vyplatí stejně jako v microservices. Nepotřebuje ho jen striktně synchronní monolit, kde publish neexistuje a všechno teče v jedné HTTP transakci.
Co dělat při dlouhodobém výpadku brokera?
Outbox jako celek je self-healing: když broker leží 30 minut, relay worker dostává timeout/connection refused, řádky zůstávají ve stavu pending, jejich počet i lag rostou – ale aplikační handlery dál zapisují události (jen do DB). Po obnovení brokera relay během několika minut vyšle backlog, lag se vrátí k normálu a subscribeři dorovnají stav. Potřeba je: (a) alert na lag > 30 s, aby tým o výpadku věděl, (b) dostatek místa v DB na nahromaděné pending řádky (typicky není problém, řádky jsou malé), (c) kompakce, která nemaže pending řádky, jen sent starší než N dní, (d) relay, který chybu spojení s brokerem nezapočítává do pokusů řádku – jinak by výpadek přesunul zdravé zprávy do failed (viz Backpressure).
Musím použít UUID/ULID, nebo stačí AUTO_INCREMENT?
Výchozí volbou je UUID v7 (případně ULID), ne AUTO_INCREMENT. Důvody: (1) UUID v7 je globálně unikátní napříč instancemi DB – nehrozí kolize při replikaci, restore z backupu nebo migraci. (2) Nese časovou složku, takže ID koreluje s pořadím vytvoření – užitečné pro debugging a pro indexové scany. (3) Klient ho může vygenerovat předem a poslat jako event_id v Idempotency-Key headeru. (4) AUTO_INCREMENT komplikuje sharding a multi-region nastavení. Komponenta Symfony Uid k tomu stačí: Uuid::v7() v entitě.