DDD a microservices – Bounded Context jako service boundary
BC = microservice je polopravda. Bounded Context je logická hranice modelu, microservice fyzická hranice nasazení. Kapitola ukazuje, kdy mapování 1:1 platí, kdy modulární monolit vyjde lépe a jak distributed monolith poznat včas.
Obsah kapitoly
Bounded Context je ohraničená oblast s jedním konzistentním doménovým modelem a jedním Ubiquitous Language. Context Mapping popsal, jak spolu kontexty komunikují, a ságy a Process Managery přidaly koordinaci procesu napříč nimi: kompenzace místo distribuovaných transakcí.
Zbývá otázka, kterou si dřív nebo později položí každý tým: jak se z logických hranic stanou fyzické nasazovací jednotky, tedy kdy se Bounded Context mapuje na microservice a kdy ne. Kapitola hájí tři teze, které se často přehlížejí. Mapování 1:1 (BC = service) je jen jedna ze tří možností. Pro většinu týmů je modulární monolit (modular monolith) rozumnější výchozí bod. A špatně navržené microservices jsou horší než monolit, kterému se snaží uniknout.
19.01 Mýtus „microservice = Bounded Context“#
V komunitě DDD a microservices koluje v různých variantách slogan: „Each microservice should be one Bounded Context.“ Kořen má v článku Jamese Lewise a Martina Fowlera Microservices (2014), kde se mluví o přirozené korelaci mezi hranicí služby a hranicí kontextu. Korelace cestou ztvrdla v rovnici: DDD vymezuje hranici modelu, microservices hranici nasazení, tak proč obojí neztotožnit. Praxe tu rovnici nepotvrzuje. Slogan je polopravda, která vede k chybným architektonickým rozhodnutím častěji než ke správným.
Podstatné je rozlišit dvě úrovně, které slogan slévá do jedné. Bounded Context je logická hranice modelu: vymezuje území, kde platí jeden konzistentní výklad pojmů, jeden Ubiquitous Language a jedna sada invariantů. Microservice je naproti tomu fyzická hranice deploymentu: jeden sestavovaný artefakt, jeden běžící proces, jedna databáze, jeden odpovědný tým. Obě úrovně se mohou překrývat, ale nemusí.
Sam Newman v knize Building Microservices, 2nd ed. (2021) tento rozdíl zdůrazňuje opakovaně. V kapitole 2 označuje Bounded Context za silného kandidáta na hranici služby. Zda kontext skutečně dostane vlastní nasazovací jednotku, rozhoduje velikost týmu, rozdílné potřeby škálování, odlišný release cyklus a operační kapacita organizace. Chris Richardson v knize Microservices Patterns (2018) v kapitole 2 popisuje stejné rozhodnutí jako dekompozici podle business capabilities a podle subdomén a zdůrazňuje, že rozdělení musí mít doménový důvod, ne čistě technický.
Eric Evans, autor pojmu Bounded Context, se na věc dívá z opačné strany. V přednášce DDD & Microservices: At Last, Some Boundaries! (QCon London 2016) tvrdí, že logické rozdělení uvnitř jednoho procesu v praxi neobstojí. Nic ho nevynucuje a hranice se postupně rozpouští. Samostatná nasazovací jednotka dodá hranici fyzickou vynutitelnost, kterou modul sám o sobě nemá. Vztah je tedy podle Evanse umožnění, ne rovnost: microservice je jeden ze způsobů, jak hranici kontextu ubránit, ne její definice. S jeho diagnózou kniha souhlasí, odpověď má ale jinou: hranici jde vynutit i uvnitř monolitu, statickou kontrolou v CI.
Ještě jedno nedorozumění: pojem „Bounded Context“ se v komunitě používá volněji, než ho definoval Eric Evans. Někdy se jím myslí pouhý modul, jindy celá produktová doména. Vaughn Vernon v knize Implementing Domain-Driven Design (2013) v kapitole 2 důrazně připomíná, že Bounded Context je jazyková hranice. Uvnitř jednoho BC má každý termín jediný význam. Když dva týmy mluví o stejném pojmu (například „Customer“) odlišně, jde o dva Bounded Contexty bez ohledu na to, zda běží v jednom, nebo ve dvou Symfony procesech.
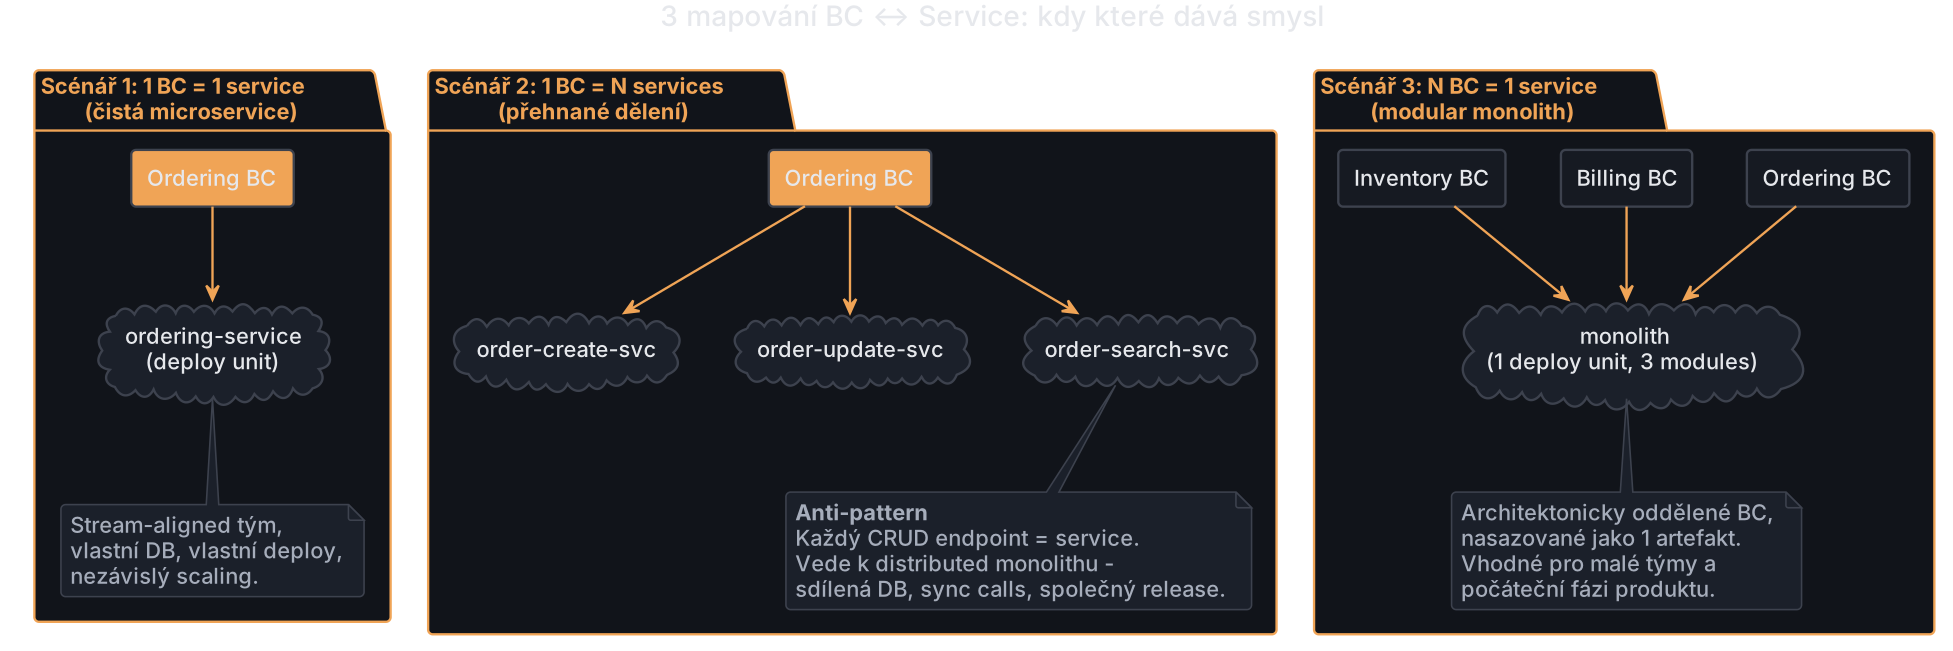
Tabulka shrnuje, čím se Bounded Context a microservice liší a v jaké rovině se o nich rozhoduje. Většina anti-vzorů v této kapitole vzniká záměnou obou úrovní.
| Aspekt | Bounded Context | Microservice |
|---|---|---|
| Hranice | Logická – model a jazyk | Fyzická – proces, deploy, DB |
| Definici zavedli | Evans 2003, Vernon 2013 | Lewis & Fowler 2014, Newman 2015 |
| Vlastník | Tým doménových expertů + vývojářů | Stream-aligned team (Skelton & Pais 2019) |
| Mění se kvůli | Změně doménového modelu | Škálování, release cyklu, provoz |
| Existuje i v monolitu | Ano, vždy – jako modul | Ne, monolit je jeden deployment |
19.02 Kdy 1 BC = 1 service (cílový stav)#
Mapování 1:1 mezi Bounded Contextem a microservice se v komunitě podává jako výchozí cíl. Automatické pravidlo to ale není: platí jen tam, kde tým splní konkrétní organizační a technické předpoklady. Sam Newman je v knize Building Microservices, 2nd ed. shrnuje pod pojmy „information hiding“ a „independent deployability“. Service má smysl, když ji lze měnit, nasazovat a škálovat nezávisle na zbytku systému. Pojem information hiding, převzatý od Davida Parnase, vysvětluje už v kapitole 1: skrýt uvnitř komponenty co nejvíc, vystavit navenek co nejméně. Na hledání hranic ho aplikuje v kapitole 2.
Kdy rozdělit BC do vlastní service
Pro vlastní nasazovací jednotku mluví tyto podmínky:
- Vlastní stream-aligned tým – kontext má vlastní tým s autonomií nad backlogem, release cyklem a operačními rozhodnutími. Bez něj je samostatná service jen administrativní zátěž navíc. Detail v Team Topologies (Skelton & Pais 2019).
- Vlastní data – kontext drží svá data v oddělené databázi (nebo alespoň v oddělených tabulkách s jediným vlastníkem schématu). Ostatní kontexty na ně nesahají přímo, jen přes API nebo události. Databáze sdílená více services je určujícím znakem distributed monolithu (viz sekci 19.04).
- Nezávislý release cyklus – kontext lze nasadit bez současného nasazení jiných kontextů. Pokud změna v service A vyžaduje současnou změnu v service B, nejde o dvě služby – tým má jednu nasazovací jednotku rozdělenou do dvou procesů.
- Rozdílné potřeby škálování – kontext má řádově jiný objem zpracování (např. catalog s velkým read trafficem vs. ordering s nízkým, ale transakčně náročným) nebo jiné latency požadavky. Rozdělení umožní horizontálně škálovat jen ten, který to potřebuje.
- Rozdílný stack nebo runtime – kontext potřebuje jiné runtime parametry (jiná PHP verze, jiné dependencies, jiné memory limity) nebo dokonce jiný jazyk. Vzácné, ale opodstatněné.
- Rozdílný compliance režim – kontext zpracovává citlivá data (PCI DSS, zvláštní kategorie osobních údajů podle GDPR), která vyžadují striktní oddělení od ostatního systému. Síťová izolace a samostatný audit trail se ve vlastní service řeší přirozeněji.
Příklad: e-shop se čtyřmi services
Ilustrativní scénář: středně velká e-commerce platforma s 30 inženýry ve čtyřech stream-aligned týmech identifikovala na workshopu Event Storming čtyři Bounded Contexty:
- Catalog – produktový katalog, search, kategorie, atributy. Read-heavy, malé write operace, agresivní cache. Tým 8 lidí.
- Ordering – košík, objednávky, stav, refundy z doménového pohledu. Transakční, citlivý na latenci, tvrdá konzistence. Tým 9 lidí.
- Payment – integrace platebních bran, autorizace, capture, recurring payments, refundy z technického pohledu. PCI DSS scope, audit trail. Tým 6 lidí.
- Shipping – integrace s dopravci, sledování, doručovací okna. Eventual consistency vůči Orderingu, dlouhý write cyklus (hodiny i dny). Tým 7 lidí.
Každý z těchto kontextů má vlastní tým, vlastní DB schema, vlastní release cyklus a měřitelně jiné potřeby škálování. Rozhodnutí mít čtyři Symfony aplikace (catalog-svc, ordering-svc, payment-svc, shipping-svc) je v této organizační realitě obhajitelné, pokud někdo unese i jejich provoz. Všech třicet inženýrů sedí ve stream-aligned týmech, takže platformu musí dodat managed služby nebo malý platformní tým, který z nich vznikne (viz operační pravidlo). Komunikují asynchronně přes Outbox a ságu typu „Place Order“.
Podstatné slovo je obhajitelné, ne „správné“. Microservices jsou rozhodnutí s kompromisy: vyšší operační složitost, potřeba distributed tracingu, eventual consistency všude, kde dříve stačila ACID transakce. Kompromisy rozebírají další sekce.
Jak velká má být jedna service
Použitelnou odpověď dává Zhamak Dehghani v článku How to break a Monolith into Microservices (2018) heslem „macro first, then micro“: začít u větších služeb postavených kolem jednoho doménového konceptu a dělit je dál, až je na to tým provozně připravený. Na pořadí záleží. Rozdělit předimenzovanou službu je refaktoring; rozplést síť dvaceti nano-services je projekt na čtvrtletí.
Druhá polovina odpovědi je Newmanovo information hiding. Dobře zvolená hranice skrývá hodně a vystavuje málo. Poznáte ji podle toho, že běžná změna se odehraje uvnitř jedné služby a nikoho jiného se nedotkne. Počet řádků kódu o kvalitě hranice neříká nic.
19.03 Kdy zvolit modular monolith#
Modulární monolit je jeden nasazovaný celek (jedna Symfony aplikace, jedna databáze, jeden proces), uvnitř něhož žije více Bounded Contextů jako modulů s vynucenými hranicemi. Zvenku vypadá jako klasický monolit, uvnitř drží disciplínu, kterou by jinak vynucovala hranice služby.
Do kapitoly o microservices patří proto, že je pro většinu týmů začínajících s DDD rozumným výchozím bodem. Podle Martina Fowlera (MonolithFirst, 2015) microservices na začátku projektu rozdělí systém dřív, než se ustálí jeho hranice, a vzniklý dluh se těžko rozplétá. Sam Newman v Building Microservices, 2nd ed. (kap. 1) označuje monolit za rozumnou výchozí architekturu. Pro nové produkty a startupy, jejichž doména se teprve hledá, považuje microservices často za špatnou volbu. Kapitola 3 o rozdělování monolitu na tento závěr odkazuje.
Konsensus to ale není. Fowler sám u MonolithFirst přiznává, že pro pevný závěr nemá dost doložených případů. Šest dní nato vyšel na jeho webu opačný názor Stefana Tilkova (Don't start with a monolith, 2015). Rozdělit existující monolit je podle Tilkova extrémně těžké: jeho části si mezitím vytvoří závislosti přes sdílené knihovny, databázi a doménové objekty. Kdo tedy ví, že cílí na microservices, měl by podle Tilkova začít rovnou u nich.
Spor rozhoduje jedna proměnná: zda se hranice uvnitř monolitu vynucují, nebo jen doporučují. Tilkovova námitka popisuje monolit bez kontroly hranic a tam platí do puntíku. S pravidly v CI, která zabrání jednomu kontextu sahat do vnitřností druhého, monolit rozdělitelnost neztrácí. Jak taková pravidla vypadají, ukazuje sekce o phparkitectu.
Kdy zvolit modulární monolit
Modulární monolit vychází lépe než microservices, když platí některý z těchto indikátorů:
- Malá organizace – pod ~30 lidí na celém produktu. Stream-aligned týmů je málo na to, aby každá service měla svůj tým. Po rozdělení pak jeden tým spravuje pět services a polovinu týdne stráví přepínáním kontextu.
- Nestabilní hranice – produkt je v rané fázi a Bounded Contexty ještě procházejí iteracemi. Refaktor hranice uvnitř monolitu je triviální (přesun souborů a tříd); refaktor přes síťovou hranici dvou services je migrace dat, koordinovaný release a Anti-Corruption Layer.
- Podobné potřeby škálování všech kontextů – pokud catalog, ordering i shipping mají podobný objem a profil, není co odděleně škálovat. Horizontální škálování celého monolitu je operačně levnější než škálování čtyř services.
- Nemáte operační platformu pro N services – žádný Kubernetes, žádný service mesh, žádné centralizované logging a tracing. Bez nich microservices technicky poběží, ale ladění incidentů bude pomalé a drahé. Více v sekci o provozu.
- Nízká operační kapacita – organizace neobsadí ani malý platformní tým pro CI/CD, observability, deploymenty a incident response. Pro zralou organizaci počítá kniha orientačně s ~15 % lidí v platformních týmech (Conway's Law a Team Topologies). Newman opakovaně připomíná, že microservices přesouvají komplexitu do provozu. Bez lidí na provoz chrání modulární monolit produktivitu týmu.
Modulární monolit v Symfony 8
V Symfony modulární monolit vzniká strukturou adresářů pod src/. Každý Bounded Context dostane vlastní namespace a podadresář, uvnitř typicky se třemi vrstvami (Domain, Application, Infrastructure). Aplikace se tak dělí nejdřív svisle podle kontextů a teprve uvnitř na vrstvy; srovnání se svislým řezem po funkcích je v kapitole o architektonických stylech:
1src/2├── Catalog/ # Bounded Context: Catalog3│ ├── Domain/4│ │ ├── Model/5│ │ │ ├── Product.php6│ │ │ └── Category.php7│ │ ├── Event/8│ │ │ └── ProductPriceChanged.php9│ │ └── Repository/10│ ├── Application/11│ │ ├── Command/12│ │ ├── Query/13│ │ └── Handler/14│ └── Infrastructure/15│ ├── Persistence/16│ └── Http/17│18├── Ordering/ # Bounded Context: Ordering19│ ├── Domain/20│ │ ├── Model/21│ │ │ └── Order.php22│ │ ├── Event/23│ │ │ └── OrderPlaced.php24│ │ └── Repository/25│ ├── Application/26│ │ ├── Command/27│ │ ├── IntegrationEvent/28│ │ │ └── ProductPriceChangedReceived.php29│ │ └── Handler/30│ └── Infrastructure/31│32├── Billing/ # Bounded Context: Billing33│ ├── Domain/34│ ├── Application/35│ │ └── IntegrationEvent/36│ │ └── OrderPlacedReceived.php37│ └── Infrastructure/38│39└── SharedKernel/ # Malá sdílená podmnožina doménového modelu40 ├── Domain/41 │ ├── Money.php42 │ └── Currency.php43 └── Application/Všimněte si dvou detailů. SharedKernel drží malou sdílenou podmnožinu doménového modelu, tedy hodnotové objekty jako Money a Currency, na jejichž výkladu se všechny kontexty shodly. Evans obsah kernelu neomezuje, sdílené entity nebo události ale zvětšují plochu, na které se musí týmy shodnout. Změna Shared Kernelu vyžaduje souhlas všech vlastníků, a protože je drahá, musí kernel zůstat malý. Namespace App\SharedKernel nese v dalších kapitolách i technické bázové typy, třeba rozhraní sběrnic nebo middleware. Jde o sdílený kód, Shared Kernel v Evansově smyslu tvoří jen jeho doménová podmnožina. Celý vzor rozebírá Context Mapping. Druhý detail: každý BC má vlastní Application/IntegrationEvent/, kam mapuje příchozí události z jiných kontextů. Stejný princip platí v sekci 19.08 i mezi samostatnými services.
Vynucení hranic přes phparkitect
Adresářová struktura sama o sobě nestačí. Vývojář pod tlakem deadlinu si do App\Ordering\Domain klidně přidá use App\Billing\Infrastructure\StripeClient; a hranice je porušená. Disciplínu drží automatická kontrola v CI. Pro PHP slouží phparkitect, statický analyzátor pravidel architektury.
Subjektem pravidla je každý kontext. Ručně psaná trojice pravidel jen pro dva kontexty nechá zbytek bez dozoru: průlom z Catalogu do Orderingu projde, protože Catalog není subjektem ničeho. Odvození ze seznamu tuto díru zavře a nový kontext stačí přidat do pole. Pravidlo 2 propustí jen identifikátory cizích kontextů, třeba App\Shipping\Domain\ValueObject\ShipmentId, protože agregáty na sebe odkazují přes ID (Návrh agregátu). Kdo chce jít dál, otočí polaritu na DependsOnlyOnTheseNamespaces, tedy whitelist, který cizí závislost odmítne i bez výčtu.
Pravidlo se spouští v CI jako součást běžné kontroly kvality:
1{2 "scripts": {3 "phparkitect": "phparkitect check --config=phparkitect.php",4 "ci": [5 "@phparkitect",6 "@phpstan",7 "@phpunit"8 ]9 }10}1- name: Architecture rules2 run: composer phparkitectS těmito pravidly lze v monolitu zůstat měsíce i roky. Závislosti mezi BC v kódu hlídá CI podobně tvrdě jako síťová hranice, za řádově nižší operační složitost. Sdílené tabulky ale phparkitect nevidí; vlastnictví dat musí hlídat oddělená schémata nebo konvence.
Kdy z modulárního monolitu odejít
Modulární monolit je výchozí stav, který některé BC časem opustí. Že je konkrétní modul připravený na vlastní service, ukazují čtyři znaky:
- Modul má výrazně jiný profil zátěže, typicky read-heavy modul (catalog, search) nebo modul s nepravidelnými špičkami (notifications, batch reporting).
- Modul má vlastní stream-aligned tým, který chce vlastní release cyklus a má operační kapacitu se postarat o samostatný runtime.
- Modul potřebuje compliance isolation (PCI DSS, zvláštní kategorie osobních údajů podle GDPR).
- Hranice modulu se posledních ~6 měsíců neměnila. Model je stabilní a refaktor přes síťovou hranici nehrozí.
Postup migrace rozebírá sekce 19.09 (Strangler Fig).
19.04 Distributed Monolith – anti-vzor#
Distributed monolith má vnější tvar microservices (N samostatných services, N deploymentů, N repozitářů, N týmů), ale vnitřní provázanost monolitu (sdílená databáze, synchronní volání všude, coordinated release, sdílená library s doménovými typy). Tým platí všechny náklady microservices bez jejich výhod; dražší způsob provozu monolitu neexistuje.
Vzniká dvěma cestami. První cesta: tým rozdělil monolit do services dříve, než identifikoval Bounded Contexty. Hranice mezi services jsou náhodné (podle technické vrstvy nebo CRUD entit), ne podle domény, takže services spolu musí komunikovat o všem. Druhá cesta: tým rozdělil správně podle BC, ale neověřil, že každá service má skutečnou autonomii. Sdílená databáze „pro jednoduchost“, sdílená library s doménovými typy „aby se neopakoval kód“, sdílená deployment pipeline „aby release byl atomický“.
Proč je horší než monolith
Distributed monolith spojuje provázanost monolitu s operační režií microservices:
- Latence. Vnitřní volání monolitu je volání funkce (~µs); volání mezi services je síťová cesta tam a zpět (~ms) plus serializace, deserializace a validace. Rozdíl tří řádů na každé volání. Při 10 vnořených voláních narostou mikrosekundy na desítky milisekund.
- Availability. Má-li každá service dostupnost 99,9 %, řetězec deseti services dosáhne 99,0 %, tedy zhruba desetinásobné nedostupnosti.
- Debugging. Trace jednoho requestu prochází N services. Bez distributed tracingu se incident dohledává velmi těžko, s ním draze.
- Refaktoring. Přesunutí pole z jedné entity do jiné je v monolitu refaktoring v IDE. Mezi services je to migrace dat, změna API kontraktů, koordinovaný deploy a období souběžného zápisu do obou míst.
- Testovací prostředí. Místo
composer install && vendor/bin/phpunitpotřebujete docker-compose s deseti kontejnery a 32 GB RAM.
Detailní rozbor obecných anti-vzorů, které k distributed monolithu vedou (microservices first, shared DB, sync everywhere), najdete v kapitole Anti-vzory a typické chyby.
Hybridní topologie – mix monolitu a extraktů
Reálné systémy do čistých kategorií „monolit“ a „microservices“ zapadají zřídka. Nejčastější je hybridní topologie: jeden modulární monolit jako core plus 1–3 extrahované services pro kontexty, které mají jasný důvod existovat samostatně.
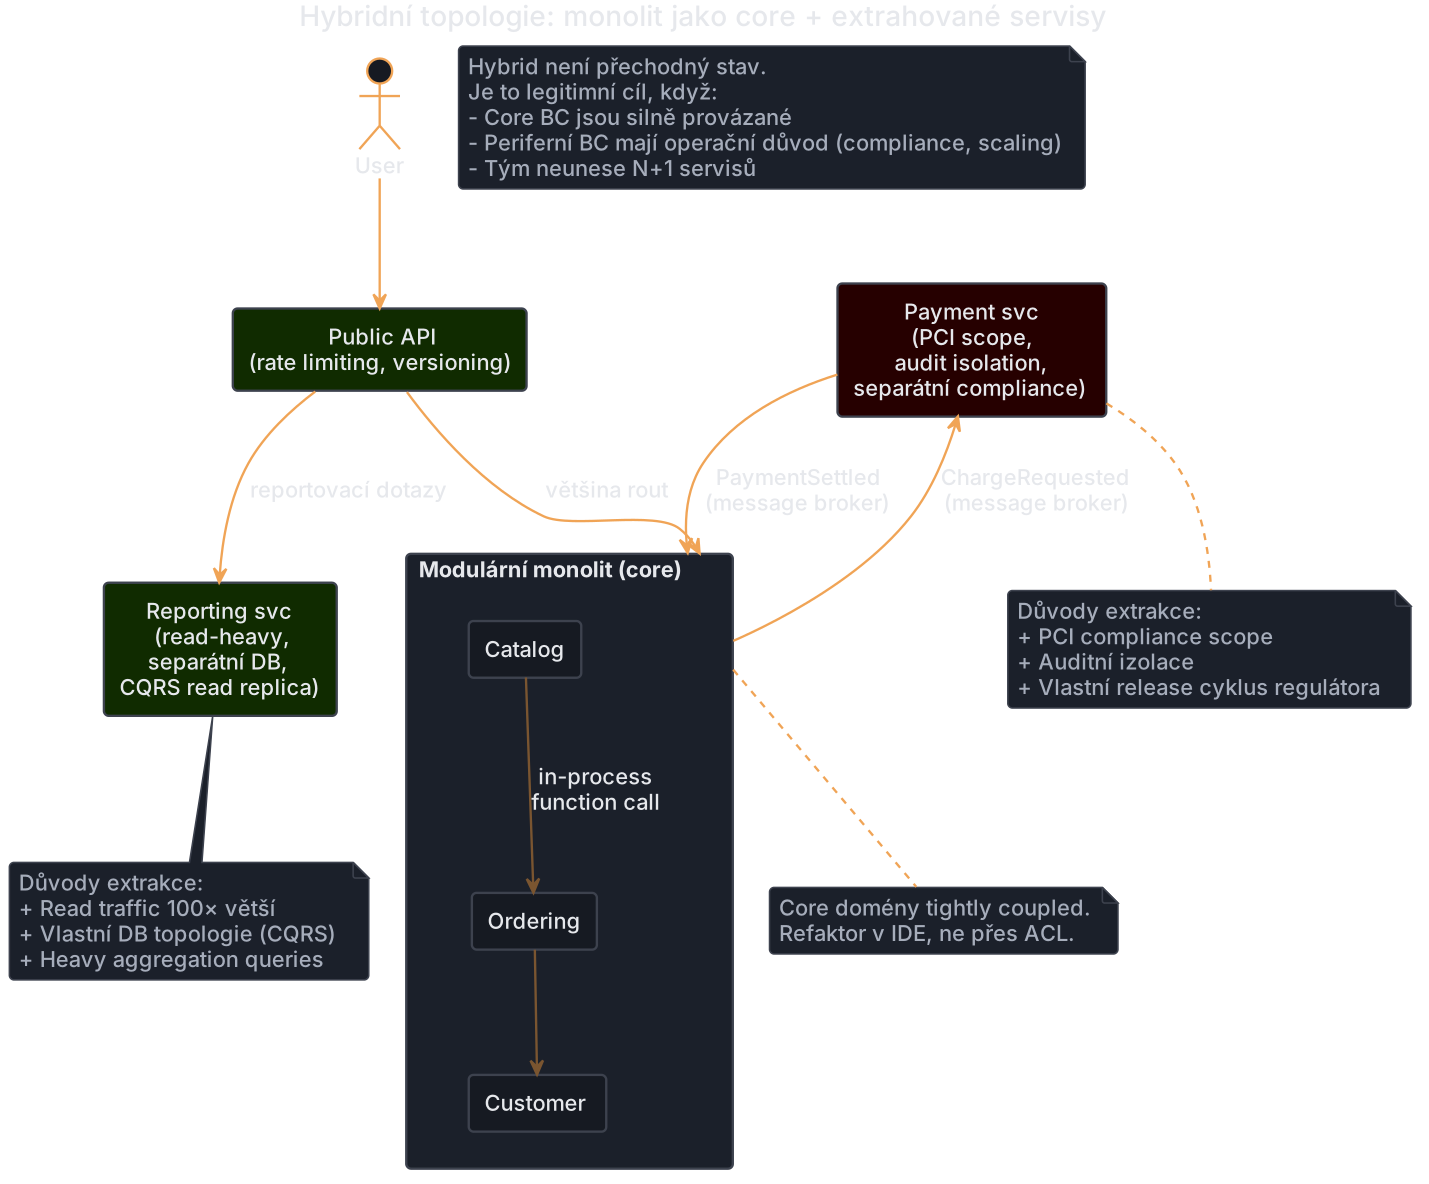
Typický scénář:
┌──────────────────────────────────┐    ┌─────────────────┐
│ Modulární monolit (core)         │ ◄──┤ Reporting svc   │
│  ├── Catalog                     │    │ (read-heavy,    │
│  ├── Ordering                    │    │  separátní DB)  │
│  └── Customer                    │    └─────────────────┘
└──────────────────────────────────┘
        ▲                    │
        │                    ▼
┌─────────────────┐    ┌──────────────────┐
│ Public API      │    │ Payment svc      │
│ (rate limiting, │    │ (PCI scope,      │
│  versioning)    │    │  audit isolation)│
└─────────────────┘    └──────────────────┘
Hybrid je plnohodnotný cíl, ne přechodný stav „dokud nedokončíme migraci na microservices“. Dlouhodobě pro něj mluví tři důvody:
- Kontexty v jádru jsou úzce provázané (Catalog ↔ Ordering ↔ Customer) a refaktor se v monolitu dělá v IDE; rozdělení do tří services přidává Anti-Corruption Layer pro každý dotaz přes hranici kontextu.
- Periferní kontexty mají jasný operační důvod být samostatně (Payment kvůli compliance, Reporting kvůli profilu zátěže, Public API kvůli SLA).
- Tým neunese N+1 services – core monolit vlastní jeden tým, každý extrakt přidá operační dluh.
De-microservicing – návrat k monolitu
Návrat od několika služeb k jednomu procesu není kacířství. Protipozice k dělení za každou cenu provází trend od začátku: Fowler ji formuloval v MonolithFirst už v roce 2015, Newman ve stejném roce v textu Microservices For Greenfield? a DHH v The Majestic Monolith (2016). Nové není přesvědčení, ale počet týmů, které mají za sebou dekádu provozu a mohou rozhodnutí revidovat s vlastními daty.
Nejcitovanějším příkladem je Amazon Prime Video (článek z března 2023, pozornost vzbudil v květnu). Kolem něj se ale nabalila historka, která s původním textem souhlasí jen zčásti:
- Co tým skutečně popsal. Komponenta Video Quality Analysis běžela jako serverless pipeline. Orchestraci zajišťovaly AWS Step Functions, výpočet běžel v Lambda funkcích a videosnímky se mezitím ukládaly do S3. Náklady rostly kvůli orchestraci a Tier-1 voláním do S3. Sloučením komponent do jednoho procesu na ECS mezisklad odpadl, data tečou v paměti a infrastrukturní náklady klesly o více než 90 %.
- Jaký to mělo rozsah. Šlo o jednu komponentu jednoho týmu, ne o Prime Video jako produkt, natož o obrat architektonické strategie Amazonu. Článek vyšel na blogu Prime Video Tech, který mezitím zanikl. Původní adresa dnes přesměrovává na aboutamazon.com, takže se text cituje přes archiv a reprinty.
- Jak to čte ten, kdo microservices zpopularizoval. Adrian Cockcroft (Netflix, později VP v AWS) na vlnu reakcí odpověděl textem So many bad takes. Podle něj šlo o dotažení serverless prototypu do produkční podoby, tedy o běžný krok ve vývoji jedné služby, ne o důkaz proti microservices obecně.
Použitelný závěr z případu vyvodil Werner Vogels v článku Monoliths are not dinosaurs (2023): jedno řešení pro všechno neexistuje a architekturu je podle něj třeba revidovat s každým řádovým růstem. Prime Video u sebe provozuje obojí: live sports streaming jako distribuovaný workflow a monitoring jako jeden proces. To je něco jiného než „microservices selhaly“.
Symptomy, které mluví pro de-microservicing:
- Latence tvořená hlavně síťovými skoky mezi services. Taková interakce má být volání funkce v jednom procesu.
- Refaktor kontextu vyžaduje současné změny v 3+ services. Hranici tým zvolil špatně; refaktor v monolitu je triviální.
- Inženýrská kapacita > 50 % na operační platformu. Tým udržuje Kubernetes, service mesh a distributed tracing místo toho, aby pracoval na produktu.
- Náklady na infrastrukturu rostou rychleji než objem provozu. AWS Lambda
- API Gateway + DynamoDB napříč 20 services stojí řádově víc než srovnatelný EC2 monolit.
- Incident MTTR > 60 minut. Ani distributed tracing nestačí k rychlému nalezení kořenové příčiny v N services.
Postup je zrcadlem extrakce ze sekce 19.09:
Náklady microservices – co se vlastně platí
Sam Newman v Building Microservices, 2nd ed. (kap. 1, sekce „Microservice Pain Points“) vyjmenovává oblasti, ve kterých microservices bolí: vývojářský komfort, technologické přetížení, náklady, reporting, monitoring a ladění, bezpečnost, testování, latenci a konzistenci dat. Rozpis níže z nich vybírá nákladovou stránku a kategorie jsou vlastní. Čísla chybí záměrně: závisejí na cloudu, regionu, mzdové hladině a na tom, kolik si tým provozuje sám. Tabulka proto říká, co se platí a čím to roste, ne kolik to stojí:
| Kategorie | Co se v ní platí | Čím roste |
|---|---|---|
| Platformní tým | Provoz orchestrátoru, service mesh, observability stacku | Počtem services a prostředí |
| Cloud infrastruktura | Více databází, message broker, load balancery, NAT | Počtem services |
| Observability | Licence APM nástrojů, retence logů a trace | Počtem hostů, metrik a spanů |
| CI/CD | N pipeline místo jedné, integrační testy přes docker-compose | Počtem services a frekvencí releasů |
| Onboarding | Pochopit topologii, deployment a ladění napříč services | Složitostí topologie |
| Incident response | Delší cesta ke kořenové příčině napříč services | Hloubkou volacích řetězců |
19.05 Kontrakt mezi services – komunikace a data#
Jakmile existují dvě services, je třeba rozhodnout, jak spolu mluví. Základní vzory jsou dva: synchronní komunikace přes REST, gRPC nebo SOAP a asynchronní přes message broker (RabbitMQ, Kafka, NATS, AWS SNS/SQS). Většina reálných systémů kombinuje obojí a volba určuje výslednou provázanost, latenci i dostupnost.
Synchronní volání – kdy
- Query (read), kde volající potřebuje odpověď během request flow. Frontend potřebuje detail produktu pro vykreslení stránky;
catalog-svcho vrátí přes REST. Bez odpovědi nemůže pokračovat. - Validace, která blokuje další krok. Před uložením objednávky musí
ordering-svcověřit ucatalog-svc, že produkt existuje a je dostupný. Volání musí být synchronní, jinak hrozí objednávka neexistujícího produktu. - Operace citlivé na latenci. Detekce podvodů v reálném čase, autorizace platby, rate limit check.
- Idempotentní lookup. Neměnné nebo zřídka měnící se data, kde latence sítě nevadí a kde pomůže cache.
Asynchronní eventy – kdy
- Změny stavu (write), u kterých volající nepotřebuje vědět, co následuje. Po uložení objednávky publikuje
ordering-svceventOrderPlaced.billing-svc,shipping-svcanotification-svcho zpracují, kdy mohou. Volající čeká jen na lokální commit. - Reakce jiných BC, které na výsledku nezávisejí. Sága postupuje krok po kroku přes události a příkazy; každý krok je samostatný.
- Operace, která může bezpečně probíhat se zpožděním. Generování faktury, odeslání e-mailu, aktualizace search indexu, generování sitemapy.
- Multi-subscriber broadcast. Jeden event konzumuje N nezávislých subscriberů; publisher o nich nemusí vědět.
Pravidlo „async-first“
Chris Richardson v Microservices Patterns (kap. 3) formuluje doporučení: přednost má asynchronní messaging, sync jen tam, kde je to objektivně nutné. Důvody:
- Asynchronní subscriber lze restartovat, opakovat, rozdělit do replik. Synchronní volající jen čeká na odpověď nebo na timeout a sám se zotavit neumí.
- Asynchronní messaging má lepší časové oddělení: subscriber může být dočasně nedostupný a publisher o tom neví. Při sync volání je volající přímo závislý na uptime volaného.
- Asynchronní toky lépe škálují: fronta zpráv se hromadí a worker ji konzumuje vlastním tempem; synchronní tok je třeba škálovat celý najednou.
- Asynchronní tok přirozeněji zapadá do modelu z Event Stormingu, který stojí právě na doménových událostech.
Asynchronní komunikaci mezi services obstará v Symfony Messenger (transport AMQP nebo Redis) v kombinaci s Outbox patternem, aby se event zapsal atomicky spolu s doménovým stavem. Detail v sekci 19.08 Symfony konkrétně.
| Aspekt | Sync (REST/gRPC) | Async (eventy) |
|---|---|---|
| Coupling v čase | Tight – volající čeká | Loose – subscriber může být offline |
| Latence vnímaná uživatelem | Součet všech sync volání | Latence lokálního zápisu |
| Availability | Součin uptime všech volaných | Jen lokální uptime + broker |
| Backpressure | Caller dostane HTTP 503 | Fronta se hromadí, worker dotahuje |
| Refactoring API | Coordinated release volajícího + volaného | Subscriber má vlastní integration event DTO |
| Testovatelnost | Vyžaduje WireMock / Pact / mock | Stačí dispatch eventu do test handleru |
Kolik dat nese událost
Osa sync/async je jen polovina rozhodnutí. Druhá se týká obsahu události. Martin Fowler v článku What do you mean by „Event-Driven“? (2017) rozlišuje čtyři vzory, které se pod tímto pojmem skrývají. Pro integraci služeb jsou podstatné dva a v praxi se pletou.
Event notification oznamuje, že se něco stalo, a nic víc. Zpráva nese identifikátor a čas; kdo chce detaily, musí si je dotáhnout zpětným voláním. Publisher zůstává štíhlý a kontrakt mezi službami minimální, ale příjemce má znovu synchronní závislost na tom, kdo událost poslal, jen posunutou o krok dál.
Event-carried state transfer nese v události všechna data, která příjemce potřebuje. Zpětné volání odpadá, subscriber si z proudu událostí staví vlastní kopii dat a přežije výpadek publishera. Platí se za to duplikací dat a širším kontraktem. Každé pole v payloadu je závazek, který někdo konzumuje.
Ukázka v sekci 19.08 patří do druhé kategorie. OrderPlacedReceived nese orderId, customerId, částku i měnu, takže billing-svc vystaví fakturu bez jediného dotazu zpět do ordering-svc. Mezi oběma režimy se volí vědomě a pro jeden směr integrace se drží jeden z nich. Míchání obou v jednom toku končí tím, že nikdo neví, která data jsou autoritativní.
Vlastnictví dat – database per service
Rozdělit kód je snazší polovina práce, těžší je rozdělit data. Chris Richardson vede Database per Service jako samostatný vzor: každá service vlastní své schéma a nikdo jiný do něj nesahá, ani na čtení. Vlastnictví tu znamená právo měnit schéma bez koordinace s kýmkoli dalším. Jakmile do tabulky čte druhá service, právo zaniká a s ním i nezávislý deploy.
Cena vzoru se ukáže, jakmile jsou potřeba data ze dvou services najednou. JOIN přes hranici neexistuje a nahrazují ho tři možnosti:
- API composition. Volající si vyžádá kus dat z každé service a složí je v paměti. Funguje pro malé výsledky. Na stránkování a řazení přes hranici se rozpadá – sestavit jednu seřazenou stránku ze dvou zdrojů znamená stáhnout oba zdroje celé.
- Read model plněný událostmi. Service si z příchozích integračních událostí staví vlastní denormalizovaný pohled a čte výhradně ze svého. Dotazy jsou rychlé, cenou je eventual consistency a duplikace. Mechanismus i jeho úskalí rozebírá kapitola o CQRS.
- Samostatný analytický sklad. Reporting a exporty do provozní databáze nepatří. Data se replikují do skladu, který vlastní reporting a který nikdo z provozních služeb nedotazuje.
Duplikovaná data potřebují pravidlo, jinak se z nich stane druhý zdroj pravdy. Kopie v cizí službě je projekce s jasným vlastníkem: jeden kontext data vytváří a publikuje, ostatní si drží read-only pohled a nikdy ho nemění za zády vlastníka. Pokud dvě services tvrdí, že vlastní totéž pole, hranice mezi nimi je špatně vedená a žádný integrační vzor to nespraví.
19.06 Distribuované transakce – sága, ne 2PC#
Jakmile doménový proces překročí hranici jednoho Bounded Contextu (v microservices architektuře tedy i hranici jedné service), vzniká otázka konzistence mezi services. ACID transakce, na kterou je tým zvyklý z jedné databáze, v distribuovaném prostředí nefunguje. Klasickou odpovědí býval Two-Phase Commit (2PC, XA transakce); v microservices architektuře je ale prakticky nepoužitelný.
Proč ne 2PC v microservices
2PC předpokládá globálního koordinátora a účastníky s XA podporou. HTTP, AMQP ani externí REST API nic z toho nenabízejí. Účastníci navíc drží zámky během obou fází a při pádu koordinátora uvíznou v in-doubt stavu. Podrobný rozbor důvodů (chybějící XA podpora brokerů, cena zámků, single point of failure, porušení autonomie kontextů) najdete v kapitole Outbox Pattern.
Sága jako odpověď
Místo jedné velké distribuované transakce sága rozdělí proces na sérii lokálních transakcí. Každou commitne jedna service do své databáze. Mezi kroky se posílají eventy nebo commands přes message broker. Když některý krok selže, sága provede kompenzační akce pro všechny předchozí úspěšné kroky. Je to sémantické vrácení, ne ACID rollback.
Sága existuje ve dvou variantách:
- Choreografie – každá service reaguje na eventy ostatních services. Žádný centrální orchestrátor; průběh vyplývá z událostí. Hodí se pro přímočarý proces bez větvení a bez čekání na lhůty.
- Orchestrace – Process Manager, komponenta řídící ságu, drží stav celého procesu a posílá commands jednotlivým services. Vyplatí se u procesů s podmínkami, timeouty, paralelními kroky a retry logikou.
O volbě rozhoduje tvar procesu, ne počet kroků (Choreografie má své místo).
Detailní implementaci ság v Symfony 8 (kompenzace, idempotence, choreografie vs. orchestrace, timeouty, paralelní kroky) probírá samostatná kapitola Ságy a Process Managery. Pro tuto kapitolu stačí dvě věci: sága je v DDD doporučovaný mechanismus pro distribuované transakce mezi microservices a platí se za ni eventual consistency a kompenzační logikou.
19.07 Service mesh, observability, provoz#
Microservices jsou především operační problém, ne programátorský. Tým, který přejde z monolitu na deset services, najednou řeší věci, které dříve obstarával operační systém a Symfony framework: routing mezi procesy, retry, circuit breaking, mTLS, distribuovaný debug, service discovery, centralizované logy, rate limiting. Každá z těchto věcí má svůj nástroj a cenu a dohromady tvoří stack, který někdo musí provozovat.
Minimum pojmenoval Martin Fowler už v roce 2014 v textu MicroservicePrerequisites: rychlé provisionování prostředí, základní monitoring a rychlý deployment aplikace, k tomu organizační posun směrem k DevOps. Kdo tyto schopnosti nemá, má si je podle Fowlera vybudovat dřív, než pustí microservices do produkce. Zbytek sekce toto minimum převádí na dnešní nástroje.
Service mesh
Service mesh (Istio, Linkerd, Consul Connect) je infrastrukturní vrstva, která řeší průřezové záležitosti komunikace mezi services:
- mTLS – vzájemná autentizace přes TLS bez ruční správy certifikátů.
- Retry a circuit breaking – automatické opakování a otevření okruhu při opakovaných selháních.
- Rate limiting – ochrana proti přetížení a zneužití na úrovni síťové vrstvy.
- Traffic shaping – canary deploy, A/B testing s percentage routing, blue/green přepínání.
- Observability – latence, chybovost a propustnost na každé hraně mezi services bez instrumentace aplikačního kódu.
Service mesh se obvykle implementuje jako sidecar: každý pod má vedle aplikačního kontejneru proxy (Envoy, linkerd-proxy), která zachytává veškerý síťový provoz a uplatňuje na něj politiky mesh. Konfigurace se ovládá přes control plane (istiod, linkerd-control).
Kdy service mesh: 10+ services, multi-team organizace, požadavek na mTLS bez ruční práce, potřeba pokročilého traffic managementu (canary, blue/green s percentage routing). Kdy ne: 3–5 services, malý tým, žádný Kubernetes. Provozní režie převáží přínosy.
Observability – three pillars
V monolitu stačila kombinace strukturovaných logů a metrik. V microservices přibývá třetí pilíř, distributed tracing. Centralizovaně se pak musí řešit všechny tři:
- Logs – centralizovaná agregace logů (ELK / Loki / CloudWatch). Každý řádek logu musí nést
trace_idaservice_name, jinak časovou řadu událostí napříč services nesložíte. - Metrics – Prometheus + Grafana, nebo cloudový ekvivalent (Datadog, New Relic). Standardní metriky (RED – rate, errors, duration) per service a per endpoint.
- Traces – OpenTelemetry + Jaeger / Tempo / Honeycomb. Jeden user request se trasuje napříč všemi services, každý skok má span. Bez toho je ladění prakticky nemožné: pět services a dvacet logů v incidentu nedá dohromady jednu časovou řadu.
Service discovery a deployment
- Service registry / discovery – Consul, Kubernetes service / DNS, AWS Cloud Map. Services nemohou spoléhat na statické IP adresy. Potřebují resolver, který v runtime vrátí adresu instance.
- Container orchestration – Kubernetes je de facto standard. Bez něj (nebo bez ekvivalentu jako Nomad, ECS) nelze realisticky provozovat víc než pár services. Kubernetes sám je netriviální a jeho provoz je vlastní specializace.
- CI/CD per service – každá service má vlastní pipeline, vlastní release schedule, vlastní rollback. Sdílená pipeline = coordinated release = distributed monolith.
- Schema registry – události přes broker (zejména Kafka) potřebují schema registry (Confluent, AWS Glue), který verzuje jejich schéma a kontroluje kompatibilitu.
Contract testing
Na čtvrtý příznak distributed monolithu ze sekce 19.04, tedy že end-to-end test vyžaduje všechny services, existuje zavedená odpověď: consumer-driven contracts. Konzument zapíše, co od poskytovatele očekává (jaká pole, jaké typy, jaké stavové kódy), a z toho vznikne kontrakt. Poskytovatel ho pak ověřuje ve vlastní pipeline, bez běžícího konzumenta. Testovací sada přestane potřebovat runtime všech N services a rozpadne se na N nezávislých sad.
Nejznámější nástroj je Pact. Jeho podpora v PHP je slabší než v Javě nebo JavaScriptu, takže napojení stojí víc práce než v jazycích, ze kterých vzor pochází. Levnější alternativou je udržovat schéma integračních událostí jako verzovaný artefakt a v CI kontrolovat, že payload z publishera projde deserializací u každého subscribera. Pokrytí je užší, ale zachytí přesně tu chybu, která v provozu bolí nejvíc. Obecnou strategii testování rozebírá kapitola o testování.
19.08 Symfony konkrétně – kdy a jak#
Symfony 8 obslouží obě architektury, modulární monolit i microservices, bez zásadní změny kódu v doménové vrstvě. Rozdíl je v konfiguraci routingu Messengeru. Uvnitř monolitu míří události a commands na sync transport (přímé volání) nebo na lokální async transport (doctrine/redis) s workerem. Mezi services míří na outbox transport, odkud je relay publikuje do RabbitMQ přes amqp transport.
Modulární monolit v Symfony
V monolitu jsou všechny BC ve stejném Symfony procesu. Integrace mezi nimi jde přes Symfony Messenger se sync transportem, tedy uvnitř procesu a v jednom DI kontejneru. Publikující BC doménovou událost na hranici přeloží na integrační událost s primitivy. Handler v druhém BC ji přijme, namapuje na vlastní DTO a spustí lokální command. Přímý odběr cizí doménové události by porušil pravidlo 3 z phparkitect konfigurace. Hranice je čistě v kódu, vynucená phparkitectem.
Ještě levnější je integrace přes port: aplikační vrstva publikujícího BC vystaví rozhraní a konzument ho implementuje. Žádné HTTP ani broker. Pokud později rozdělíte BC do services, port zůstane stejný, jen se za ním objeví HTTP klient nebo Messenger.
Microservice v Symfony
V architektuře microservices je každý BC samostatná Symfony aplikace s vlastním composer.json, config/, src/ a databází. Integrace reagující na změny stavu probíhá asynchronně (synchronní dotazy a validace ze sekce 19.05 stranou) přes Symfony Messenger s AMQP transportem (RabbitMQ) v kombinaci s Outbox patternem v publisheru a Inbox idempotency v subscriberovi.
Pravidlo: publisher a subscriber nesdílejí PHP třídu eventu. Publisher má v ordering-svc vlastní třídy: doménovou App\Ordering\Domain\Event\OrderPlaced a z ní sestavenou integrační OrderPlacedIntegrationEvent z kapitoly Outbox Pattern. Subscriber v billing-svc má vlastní App\Billing\Application\IntegrationEvent\OrderPlacedReceived, samostatnou třídu, která se naplní z deserializovaného AMQP payloadu. Důvody jsou v sekci 19.04 (sdílená library s doménovými typy = distributed monolith).
Outbox transport zapisuje událost do tabulky ve stejné DB transakci jako doménový commit. Místo vlastní tabulky outbox s entitou OutboxMessage z kapitoly Outbox Pattern tu jako outbox slouží tabulka Doctrine transportu (messenger_messages, fronta outbox_events). Princip je týž, schéma ale patří Messengeru. Vestavěný relay mezi dvěma transporty ale Messenger nemá, takže zprávy z events_out do amqp_out samy nepřetečou. Relay je vlastní kód: console command nebo handler, který záznamy z outbox tabulky čte a jejich payload publikuje na AMQP transport. Implementaci relay procesu včetně pollingu a ošetření duplicit popisuje Outbox Pattern.
Subscriber service má zrcadlovou konfiguraci: AMQP transport pro příchozí zprávy, vlastní mapping na integration event DTO a lokální command bus pro spuštění reakce. Lokální transport se v obou službách jmenuje prostě async, protože každá služba má vlastní messenger.yaml. Monolit z ostatních kapitol dělí asynchronní zprávy do transportů async_commands a async_events.
IntegrationEventSerializer je vlastní serializer, který namapuje AMQP payload (typicky JSON) na konkrétní třídu integration eventu. Subscriber se rozhoduje podle řetězce event_type v hlavičce, ne podle PHP typu, a tím se od publishera plně oddělí na úrovni kódu.
Ten event_type musí ale někdo nastavit. Vestavěné serializery Messengeru ho neposílají.
Výchozí messenger.transport.native_php_serializer pošle celou obálku jako serializovaný
PHP objekt bez hlaviček; přečte ho jen PHP konzument se stejnou třídou. Alternativní
messenger.transport.symfony_serializer dá do hlaviček type s plným jménem PHP třídy
a tělo odvodí z jejích vlastností, takže každé přejmenování vlastnosti mění kontrakt.
Konzument z této sekce čeká hlavičku event_type a pole včetně měny,
takže s kterýmkoli z nich dostane Missing event_type header. Vydavatel proto
potřebuje vlastní serializer, který událost přeloží do dohodnutého tvaru:
1<?php2 3declare(strict_types=1);4 5namespace App\Ordering\Infrastructure\Messaging;6 7use App\Ordering\Application\IntegrationEvent\OrderPlacedIntegrationEvent;8use Symfony\Component\Messenger\Envelope;9use Symfony\Component\Messenger\Transport\Serialization\SerializerInterface;10 11/**12 * Encode-only: převádí integrační událost na dohodnutý wire formát.13 * Tvar payloadu je součástí Published Language, ne detail implementace,14 * takže se nesmí měnit spolu s PHP třídou.15 */16final class OutboundEventSerializer implements SerializerInterface17{18 /** @param array<string, mixed> $encodedEnvelope */19 public function decode(array $encodedEnvelope): Envelope20 {21 throw new \LogicException('OutboundEventSerializer is encode-only.');22 }23 24 /** @return array<string, mixed> */25 public function encode(Envelope $envelope): array26 {27 $event = $envelope->getMessage();28 29 if (!$event instanceof OrderPlacedIntegrationEvent) {30 throw new \LogicException($event::class . ' has no agreed wire format.');31 }32 33 return [34 'body' => json_encode([35 'eventId' => (string) $event->eventId,36 'occurredAt' => $event->occurredAt->format(\DateTimeInterface::ATOM),37 'orderId' => $event->orderId,38 'customerId' => $event->customerId,39 'totalAmountCents' => $event->totalAmountCents,40 // Integrační událost měnu nenese: obchod v knize účtuje v jedné41 // měně (placeWithItems() zakládá položky v CZK). Na drát jde42 // přesto výslovně, příjemce ji nemá hádat.43 'currency' => 'CZK',44 ], JSON_THROW_ON_ERROR),45 'headers' => ['event_type' => 'ordering.order_placed'],46 ];47 }48}Dvojice „vlastní DTO plus překladová vrstva na hranici“ je Anti-Corruption Layer z Context Mappingu, jen realizovaný přes serializer místo přes klientskou třídu. Ostatní vztahy z Context Map mají v microservices architektuře stejně přímočarý protějšek:
| Vztah z Context Map | Mechanismus mezi services |
|---|---|
| Anti-Corruption Layer | Vlastní integration event DTO a serializer, který na něj překládá cizí payload |
| Open Host Service + Published Language | Veřejné API nebo publikované schéma událostí se zpětnou kompatibilitou |
| Conformist | Přebírání schématu publishera beze změny, typicky u reportingu nebo průchozího kontextu bez vlastní logiky nad převzatými daty |
| Separate Ways | Žádná integrace – data se pořizují znovu, protože překlad by stál víc |
1<?php2 3declare(strict_types=1);4 5namespace App\Billing\Infrastructure\Messaging;6 7use App\Billing\Application\IntegrationEvent\OrderCancelledReceived;8use App\Billing\Application\IntegrationEvent\OrderPlacedReceived;9use Symfony\Component\Messenger\Envelope;10use Symfony\Component\Messenger\Exception\MessageDecodingFailedException;11use Symfony\Component\Messenger\Transport\Serialization\SerializerInterface;12 13final readonly class IntegrationEventSerializer implements SerializerInterface14{15 /**16 * Mapping event_type hlavičky -> integration event třída.17 * Když publisher přidá nový event_type, doplníme tu řádek;18 * dokud nedoplníme, dekódování selže.19 *20 * Selhání dekódování MUSÍ být MessageDecodingFailedException.21 * Od Symfony 8.1 s ní receiver pošle zprávu běžnou retry/failure22 * cestou do failure transportu. Na 8.0 ji AmqpReceiver jen rejectne,23 * takže přežije pouze v dead-letter exchange nastavené na frontě.24 * Jiná výjimka shodí worker, zpráva zůstane neackovaná a po restartu25 * se vrátí znovu – nekonečná smyčka nad jedinou vadnou zprávou.26 */27 private const TYPE_MAP = [28 'ordering.order_placed' => OrderPlacedReceived::class,29 'ordering.order_cancelled' => OrderCancelledReceived::class,30 ];31 32 public function decode(array $encodedEnvelope): Envelope33 {34 $headers = $encodedEnvelope['headers'] ?? [];35 $eventType = $headers['event_type']36 ?? throw new MessageDecodingFailedException('Missing event_type header');37 38 $targetClass = self::TYPE_MAP[$eventType] ?? throw new MessageDecodingFailedException(39 sprintf('Unknown event_type: %s', $eventType)40 );41 42 try {43 $payload = json_decode($encodedEnvelope['body'], true, flags: JSON_THROW_ON_ERROR);44 } catch (\JsonException $e) {45 throw new MessageDecodingFailedException('Body is not valid JSON', 0, $e);46 }47 if (!is_array($payload)) {48 throw new MessageDecodingFailedException('Body is not a JSON object');49 }50 51 // Mapping payloadu z publishera na náš subscriber-side DTO.52 // Každý typ eventu nese jiná pole, proto se tu větví. Defenzivní –53 // žádná pole z payloadu, která bychom nepoužívali.54 try {55 $message = match ($targetClass) {56 OrderPlacedReceived::class => new OrderPlacedReceived(57 eventId: $payload['eventId'],58 occurredAt: $payload['occurredAt'],59 orderId: $payload['orderId'],60 customerId: $payload['customerId'],61 totalAmountCents: $payload['totalAmountCents'],62 currency: $payload['currency'] ?? 'CZK',63 ),64 OrderCancelledReceived::class => new OrderCancelledReceived(65 eventId: $payload['eventId'],66 occurredAt: $payload['occurredAt'],67 orderId: $payload['orderId'],68 reason: $payload['reason'] ?? null,69 ),70 };71 } catch (\TypeError|\ErrorException $e) {72 // Chybějící pole dorazí jako null, pole jiného typu neprojde73 // strict_types – obojí shodí konstruktor DTO TypeErrorem.74 // ErrorException přidává ErrorHandler Symfony v debug režimu75 // z varování „Undefined array key“. Vadná zpráva, ne pád workeru.76 throw new MessageDecodingFailedException(77 sprintf('Invalid payload for event_type %s', $eventType), 0, $e,78 );79 }80 81 return new Envelope($message);82 }83 84 public function encode(Envelope $envelope): array85 {86 // Subscriber encode neprovádí – to dělá publisher na své straně.87 // Důsledek pro konfiguraci: transport s tímto serializerem nesmí mít88 // retry_strategy, protože retry posílá envelope zpět přes encode().89 // Selhání proto řeší failure_transport s výchozím serializerem.90 throw new \LogicException('IntegrationEventSerializer is decode-only.');91 }92}Serializer je jediné místo v subscriberu, které zná formát publishera. Změna payloadu na straně publishera zasáhne jen sem, zbytek kódu pracuje s vlastní třídou.
Handler integration eventu
Po deserializaci přebírá zprávu běžný Messenger handler a převede ji na lokální command vlastního BC:
1<?php2 3declare(strict_types=1);4 5namespace App\Billing\Application\Handler;6 7use App\Billing\Application\Command\CreateInvoiceForOrder;8use App\Billing\Application\IntegrationEvent\OrderPlacedReceived;9use App\Inbox\Application\InboxRepository;10use Doctrine\DBAL\Exception\UniqueConstraintViolationException;11use Symfony\Component\Messenger\Attribute\AsMessageHandler;12use Symfony\Component\Messenger\Exception\HandlerFailedException;13use Symfony\Component\Messenger\MessageBusInterface;14use Symfony\Component\Uid\Uuid;15 16#[AsMessageHandler]17final readonly class OrderPlacedReceivedHandler18{19 // Jméno konzumenta v inboxu; unikátní je dvojice (event_id, consumer).20 public const string CONSUMER = 'billing.create_invoice';21 22 public function __construct(23 private MessageBusInterface $commandBus,24 private InboxRepository $inbox,25 ) {}26 27 public function __invoke(OrderPlacedReceived $event): void28 {29 // Rychlá zkratka pro zjevné duplikáty. Autoritativní není –30 // mezi kontrolou a zápisem může projít paralelní doručení.31 // Detail v /outbox-pattern#inbox32 if ($this->inbox->isProcessed(Uuid::fromString($event->eventId), self::CONSUMER)) {33 return;34 }35 36 // eventId putuje do commandu. Handler commandu zapíše do inboxu37 // dvojici (eventId, CONSUMER) ve stejné transakci jako fakturu;38 // o transakci se stará doctrine_transaction middleware na command.bus.39 // Unikátní index nad (event_id, consumer) duplikát odmítne a celá40 // transakce se vrátí zpět.41 try {42 $this->commandBus->dispatch(new CreateInvoiceForOrder(43 eventId: $event->eventId,44 orderId: $event->orderId,45 customerId: $event->customerId,46 amountCents: $event->totalAmountCents,47 currency: $event->currency,48 ));49 } catch (HandlerFailedException $e) {50 // Bez tohoto catche skončí skutečný duplikát ve failed transportu.51 // Rollback je správný, ale zprávu je potřeba potvrdit, ne opakovat.52 foreach ($e->getWrappedExceptions() as $wrapped) {53 if (!$wrapped instanceof UniqueConstraintViolationException) {54 throw $e;55 }56 }57 }58 }59}Vzor zajistí čtyři vlastnosti:
- Žádný sdílený kód mezi services – billing-svc nemá ve svém
composer.jsonžádný balíček, který by definoval třídy ordering-svc. - Verzování payloadu – publisher přidá pole a subscriber ho, dokud ho nepotřebuje, ignoruje. Koordinovaný release odpadá. Nový
event_type(napříkladordering.order_placed.v2) potřebuje jen rozbíjející změna: přejmenované nebo odebrané pole, jiný význam hodnoty. - Idempotence – duplicitní doručení (failover brokeru, restart workera) se neprojeví. Inbox tabulka v billing-svc drží zpracované dvojice
eventIda konzumenta se stejným rozhraním jako v kapitole Outbox Pattern. Kontrola v handleru integrační události je jen zkratka pro zjevné duplikáty; autoritativní je unikátní index nad touto dvojicí a zápis do inboxu ve stejné transakci jako doménová změna. Kontrola oddělená od zápisu paralelní duplikát nezastaví. Odmítnutý duplikát ale handler musí zachytit a zprávu potvrdit; jinak skončí ve failure transportu, přestože se systém zachoval správně. - Testovatelnost – handler se testuje s
new OrderPlacedReceived(...), bez síťového stacku.
Ekonomika microservices v PHP
Literatura o microservices vznikla nad dlouho běžícími runtime: JVM, .NET, Node. PHP v klasickém režimu php-fpm počítá jinak a několik doporučení se tím posouvá. V knihách o microservices tato část kalkulace chybí, protože ji jejich autoři nepotřebovali.
Aplikace je shared-nothing: bootstrapuje se při každém requestu a mezi requesty si nedrží ani in-process cache, ani connection pool. Každá extrahovaná služba tedy platí vlastní bootstrap na vlastním requestu. Samo o sobě je to drobnost, jenže se násobí počtem skoků v řetězci.
Podstatnější je chování synchronního volání. Node nebo Go čekají na odpověď neblokujícím I/O prakticky zadarmo. Naproti tomu php-fpm child zůstává po celou dobu round-tripu obsazený a nikoho jiného neobslouží. Počet childů je pevný, takže fan-out do tří služeb spotřebuje trojnásobek konkurenční kapacity volajícího. Anti-vzor „synchronní orchestrace všeho přes REST“ ze sekce 19.10 je proto v PHP dražší než v prostředí, ze kterého pochází zdrojová literatura.
Zmírnit to jde dvěma způsoby:
- Souběžné requesty přes
HttpClient. SymfonyHttpClientstreamuje odpovědi, takže tři volání lze poslat najednou a čekat na ně současně. Trojí sériové->getContent()latence zbytečně sčítá. - Worker režimy. FrankenPHP, RoadRunner nebo Swoole drží aplikaci v paměti mezi requesty. Bootstrap odpadá a cena synchronního volání klesá. Cenou je, že služby se stavem vázaným na request musí implementovat
Symfony\Contracts\Service\ResetInterface, jinak stav prosákne do dalšího requestu.
Opačným směrem působí levná nasazovací jednotka: není co kompilovat, odpadá warm-up JVM a image se sestaví za minuty. Technicky je extrakce služby v PHP snazší než v Javě, takže náklad leží téměř celý v provozu. Hlavní tezi kapitoly to spíš posiluje.
Provoz má v Symfony konkrétní podobu. Každá služba, která konzumuje zprávy, potřebuje vlastní sadu workerů: messenger:consume pod Supervisorem nebo systemd, --memory-limit a --time-limit proti narůstající spotřebě paměti a messenger:stop-workers v každém deploy skriptu. Pět služeb znamená pět takových konfigurací a pět míst, kde se dá na restart workerů po deployi zapomenout. Messenger na provoz nabízí i dva novější přepínače: --keepalive brání předčasnému redelivery u dlouho běžících handlerů a --fetch-size (od Symfony 8.1) snižuje počet dotazů do transportu při dávkovém zpracování.
19.09 Postupná migrace monolit → microservices#
Většina reálných systémů nevzniká jako microservices na zelené louce. Vzniká jako monolit, který časem začne bolet, a teprve pak přijde otázka, kterou část oddělit. Sekce vychází z Newmanova doporučení v Building Microservices, 2nd ed. vyhnout se přepisu naráz (big-bang rewrite). Velký přepis selhává mnohem častěji, než tým při plánování čeká.
Strangler Fig Pattern
Strangler Fig (Martin Fowler, 2004; pod tímto názvem od roku 2019) nahrazuje systém po částech: fasáda před monolitem přesměrovává provoz jednotlivých Bounded Contextů na nově extrahované services a rollback zůstává po celou dobu možný.
Fowlerova současná verze textu přidává pojem transitional architecture: fasáda, dvojí zápis a routovací vrstva jsou dočasné lešení, které do cílového stavu nepatří a po migraci se bourá. Kdo si ho ponechá „pro jistotu“, zůstane s trvale složitější topologií, než jakou potřebuje.
Plný výklad vzoru je v kapitole Migrace z CRUD na DDD: princip koexistence staré a nové části, struktura projektu i srovnání s přímým přepisem. Zde jde jen o to, co je specifické pro extrakci do samostatných services: pořadí fází a kritéria, kdy přestat.
Tři fáze migrace v praxi
Postup pro Symfony tým, který má monolit bez vynucených hranic:
Fáze 1: Modulární monolit (3–12 měsíců)
Cíl: identifikovat Bounded Contexty a vynutit jejich hranice uvnitř jednoho deployu. Nemigruje se nikam – refaktoruje se struktura.
- Provést Event Storming nebo Domain Storytelling s doménovými experty. Identifikovat BC.
- Reorganizovat
src/dosrc/<BC>/struktury. Každý BC má vlastní Domain / Application / Infrastructure. - Zavést phparkitect pravidla a v CI je vynucovat. Bez tohoto kroku jsou hranice fiktivní.
- Cross-BC integraci převést na Domain Events + Symfony Messenger (sync transport zatím).
- Identifikovat schema ownership, tedy která tabulka patří kterému BC. Tabulka, která patří dvěma BC, znamená buď Shared Kernel (vzácně), nebo špatně vedenou hranici.
Fáze 2: Strangler Fig – první extrakce (1–3 měsíce na první service)
Cíl: vytáhnout první BC do samostatné service. Vyberte ten, který má největší důvod (typicky read-heavy modul s odlišným profilem zátěže nebo modul s compliance isolation).
- Postavte fasádu (Symfony API gateway, nginx routing, AWS API Gateway) před monolit.
- Postavte nový Symfony projekt jako samostatnou service. Zkopírujte (nikdy ne
git mv) kód cílového BC z monolitu. - Migrace dat: tabulky cílového BC postupně replikujte do nové DB. Nastane období dual-write, kdy píší monolit i nová service. Čtecí provoz přepínejte postupně. Dual-write je zde vědomá výjimka: kapitola o Outboxu ho popisuje jako problém, protože zápis do dvou úložišť není atomický. Při migraci je únosný jako řízený a časově omezený stav, s jedním úložištěm jako zdrojem pravdy a s pravidelnou rekonciliací, která rozdíly najde a srovná. Trvalé řešení z něj nedělejte.
- Cross-BC eventy převeďte na AMQP transport Messengeru. Subscriber má vlastní integration event DTO (sekce 19.08).
- Po stabilizaci smažte zbytky cílového BC z monolitu.
Fáze 3: Iterace nebo zastavení
Cíl: rozhodnout, zda pokračovat dalším BC, nebo zastavit a žít s hybridní architekturou (monolit + 1–2 services). Hybrid je plnohodnotný cíl, ne dočasná fáze. Mnoho úspěšných systémů k čisté microservices architektuře nikdy nedospěje, protože k tomu nemá důvod.
- Změřit, zda první extrakce splnila očekávání (lepší škálování, rychlejší release, lepší vlastnictví). Pokud ne, zastavit a analyzovat proč.
- Pokračovat dalším BC, který má jasné odůvodnění.
- Investovat průběžně do operační platformy. Bez ní každá další extrakce zhoršuje produktivitu.
19.10 Anti-vzory v microservices a DDD#
Pět nejčastějších anti-vzorů při kombinaci DDD a microservices, každý s konkrétním symptomem a opravou.
1. Microservices first (před identifikací BC)
Symptom: tým rozdělil monolit do services dříve, než provedl Event Storming nebo Domain Storytelling. Hranice services odpovídají technickým vrstvám (auth-svc, user-svc, db-svc) nebo CRUD entitám (order-svc, customer-svc, product-svc), ne doménovým kontextům.
Důsledek: doménový proces musí projít pěti až deseti services a všude narazí na synchronní provázanost. Jde o distributed monolith z definice.
Oprava: zastavit, identifikovat skutečné BC přes Event Storming, mapovat aktuální services na cílové BC. Často se ukáže, že tři stávající services patří do jednoho BC. Sloučit je do modulárního monolitu a teprve pak řešit, zda BC má dostat vlastní service.
2. Sdílená databáze napříč services
Symptom: service A i service B čtou (nebo dokonce zapisují) do stejných tabulek. „Jednoduchá integrace“, „atomicita“, „není čas dělat to správně“.
Důsledek: jakákoli změna schématu zlomí všechny services, které tabulku konzumují. Žádná service data nevlastní. Každý refaktoring databáze znamená koordinovanou migraci všech konzumentů.
Oprava: data dělit podle BC. Cross-BC čtení nahradit voláním API (sync) nebo replikací přes eventy (async, eventually consistent). Žádný cross-BC join na DB úrovni. Kanonickou podobu anti-vzoru s ukázkami kódu popisují Anti-vzory.
3. Synchronní orchestrace všeho přes REST
Symptom: každá doménová operace je řetězec sync HTTP volání. Vyřízení objednávky: ordering volá payment, payment volá fraud-detection, fraud-detection volá ai-scoring, ai-scoring volá customer, ... Jeden user request = 12 vnořených HTTP volání.
Důsledek: latence se sčítá do sekund, dostupnost se násobí a výpadky spouštějí retry storm.
Oprava: aplikovat async-first pravidlo (sekce 19.05). Změny stavu přes události, validační dotazy synchronně s cache, žádné synchronní vedlejší efekty (zápisy) přes hranici service. Pro koordinaci procesů použít ságu.
4. Jeden deployment artefakt pro N services
Symptom: CI/CD pipeline sestavuje všechny services společně. Release schedule je centralizovaný („máme deployment train“, „release window v úterý“). Změnu v jedné service nelze nasadit bez ostatních.
Důsledek: všechny services musí být kompatibilní v každém okamžiku. Postupný rollout, přepínání funkcí ani rychlý rollback nejsou možné. Coupled deploy je definující znak distributed monolithu.
Oprava: každá service má vlastní pipeline, vlastní release cyklus, vlastní rollback. Cross-service kompatibilita se řeší verzováním schématu a verzováním integration eventů (subscriber přijímá starší i novější verzi).
5. Nano-services
Symptom: service o 50 řádcích kódu, vlastní deploy, vlastní DB. „Single responsibility principle“ aplikované na nasazovací jednotku. Sto services pro produkt s 30 inženýry.
Důsledek: stonásobná operační režie. Každá service potřebuje monitoring, alerty, CI/CD, runtime, znalostní bázi, pohotovostní rotaci. Tým 30 lidí má na service 0,3 inženýra. Nikdo nemá hluboké vlastnictví, všichni „udržují“.
Oprava: agregovat blízce příbuzné services do jedné, typicky sloučit do BC, do kterého patří. „Microservice“ znamená samostatně nasazovatelnou jednotku, ne „malou service“. Velikost je vedlejší. Sam Newman v Building Microservices, 2nd ed. staví hranice services na information hidingu, provázanosti a soudržnosti, tedy na doméně, ne na technické gymnastice.
Obecnější rozbor anti-vzorů v DDD (nejen microservices) najdete v kapitole Anti-vzory.
19.11 Shrnutí#
Bounded Context je logická hranice modelu, microservice fyzická hranice deploymentu. Mapování mezi nimi je 1:1, 1:N nebo N:1 a slogan „BC = microservice“ slouží jen jako výchozí hypotéza.
Kapitola nese jediné rozhodnutí: kudy vede hranice mezi procesy. Pro tým do třiceti lidí ji nejlevněji uhlídá modulární monolit. Závislosti mezi BC v kódu vynutí phparkitect za zlomek operační složitosti. Samostatnou service si BC zaslouží, když splní aspoň čtyři podmínky ze sekce 19.02: vlastní stream-aligned tým, vlastní data, nezávislý release cyklus, jiné potřeby škálování, odlišný stack, compliance isolation. Tři a méně znamená zůstat v monolitu.
Když už hranice vede přes síť, drží ji tři pravidla. Data mají jednoho vlastníka: jedno schéma se dvěma zapisovateli je porucha, dotaz přes hranici řeší API composition, read model plněný událostmi nebo analytický sklad. Komunikace je async-first. Sync zůstává jen pro dotazy v request flow a blokující validace, protože těsná časová vazba ubere z microservices přesně to, kvůli čemu vznikly. A konzistenci mezi službami zajišťuje sága s kompenzacemi, ne 2PC, které v tomhle stacku není použitelné.
Symfony Messenger obslouží oba světy: sync transport uvnitř monolitu, AMQP transport s Outboxem mezi službami. Jedno pravidlo je přitom nepřekročitelné: publisher a subscriber nesdílejí PHP třídu události, subscriber má vlastní integration event DTO. Sdílená knihovna s doménovými typy patří k příznakům distributed monolithu ze sekce 19.04, stejně jako sdílená databáze a synchronní volání všude. A distributed monolith je horší než monolit, se kterým jste začínali.
Cesta z monolitu vede přes Strangler Fig: jeden BC po druhém, s fasádou a s obdobím souběžného zápisu, ve kterém zůstává jedno úložiště zdrojem pravdy (fáze 2). Big-bang rewrite zpravidla selže. A pokud nemáte orchestrátor, distributed tracing, service discovery a CI/CD per service, je odpovědí na otázku po hranici stejně modulární monolit.
19.12 Další četba#
- Sam Newman – Building Microservices, 2nd ed. (O'Reilly, 2021). Kanonická kniha o microservices. Kapitola 1 pro monolit jako výchozí volbu, kapitoly 1–2 pro hranice services, kapitola 3 pro migraci, kapitoly 4–6 pro integraci.
- Chris Richardson – Microservices Patterns (Manning, 2018). Praktická kniha plná konkrétních vzorů. Kapitola 2 (dekompozice podle business capabilities a subdomén), kapitola 3 (interprocess communication), kapitola 4 (sagas), kapitola 13 (refaktoring monolitu).
- Vaughn Vernon – Implementing Domain-Driven Design (Addison-Wesley, 2013). Kapitola 2 pro Bounded Context jako jazykovou hranici, kapitola 3 pro Context Maps, kapitola 8 pro Domain Events napříč BC.
- James Lewis & Martin Fowler – Microservices (2014). Text, který pojem ustavil. Devět charakteristik architektury a formulace o „přirozené korelaci“ mezi hranicí služby a hranicí kontextu, ze které vznikl slogan rozebíraný v sekci 19.01.
- Martin Fowler – MonolithFirst (2015). Krátký esej, který formuloval doporučení nezačínat na zelené louce s microservices.
- Stefan Tilkov – Don't start with a monolith (2015). Protipozice publikovaná na Fowlerově vlastním webu šest dní po MonolithFirst. Čtěte obojí, ne jen jedno.
- Zhamak Dehghani – How to break a Monolith into Microservices (2018). Heslo „macro first, then micro“ a nejčastější chyba migrace: postavit novou službu a nezrušit původní cestu v monolitu.
- Martin Fowler – What do you mean by „Event-Driven“? (2017). Event notification, event-carried state transfer, event sourcing a CQRS jako čtyři různé věci pod jedním názvem.
- Werner Vogels – Monoliths are not dinosaurs (2023). Rámec k případu Prime Video: architektura se reviduje s každým řádovým růstem.
- Martin Fowler – Strangler Fig Application (2004, přejmenováno 2019). Originální popis migrační strategie použitelný pro každý legacy systém. Současná verze textu přidává transitional architecture, tedy dočasné lešení, které se po migraci bourá.
- Matthew Skelton & Manuel Pais – Team Topologies (IT Revolution, 2019). Stream-aligned teams, enabling teams, complicated subsystem teams, platform teams. Klíč k tomu, aby microservices měly smysl organizačně.
- Martin Fowler – Microservice Trade-Offs (2015). Co získáte a co ztrácíte.
Časté otázky
Kolik je správná velikost jednoho microservice?
Velikost není primární kritérium, tím je nezávislá nasaditelnost. Microservice je správně velký tehdy, když ho jeden stream-aligned tým dokáže měnit, nasazovat a provozovat samostatně. To může být 500 řádků kódu nebo 50 000. Sam Newman v Building Microservices, 2nd ed. doporučuje, aby velikost vznikala z domény (jeden Bounded Context nebo logická část), ne z technického ideálu „malé service“. Detail v sekci 19.02 a v anti-vzoru nano-services.
Můžu mít 2 Bounded Contexty v jedné microservice?
Ano, a často je to správné rozhodnutí. Je to definice modulárního monolitu nebo malého „mikro-monolitu“. Pokud dva BC sdílejí stream-aligned tým a podobné potřeby škálování, je jejich provoz ve dvou samostatných services režie bez přínosu. Hlavní podmínka: hranice mezi BC uvnitř service musí být vynucená kódem (typicky phparkitect pravidly). Pokud se hranice obcházejí, máte nestrukturovaný monolit, ne modulární monolit. Detail v sekci 19.03.
Kdy přejít z monolitu na microservices?
Když máte konkrétní bolest, kterou microservices skutečně řeší: typicky odlišné potřeby škálování jednoho modulu, různé compliance režimy nebo organizační oddělení (různé stream-aligned týmy s různými release cykly). Bez konkrétní bolesti přinese přechod jen operační složitost. Postup vždy přes Strangler Fig (postupná extrakce 1 BC v čase), nikdy big-bang rewrite. Detail v sekci 19.09.
Co je BFF (Backend For Frontend) a kam patří v DDD?
BFF je vzor, ve kterém má každý frontend (web, mobile, partner API) vlastní backend agregátor, který volá downstream microservices a sestavuje view-model přesně přizpůsobený danému klientovi. V DDD terminologii je BFF downstream konzument volaných služeb: využívá jejich Open Host Service a Published Language a proti jejich modelům staví Anti-Corruption Layer. Sám OHS není. OHS je protokol otevřený všem konzumentům, kdežto BFF slouží jedinému klientovi. Doménovou logiku nenese; je to integrační vrstva s vlastním modelem obrazovek, kterou lze vést jako samostatný kontext (typicky „Web Frontend“).
GraphQL Federation jako náhrada microservices integrace?
GraphQL Federation umožňuje, aby více services vystavilo svou část schématu a aby gateway (Apollo Router) je z pohledu klienta sloučila do jednoho schématu. Pro read operace přes microservices odstíní klienta od fyzického rozdělení. Pro write operace federation neřeší distribuované transakce; pořád potřebujete ságu. Federation se proto hodí jako fasáda pro čtení, ne jako náhrada architektury řízené událostmi.
Která service vlastní data o zákazníkovi napříč BC?
Žádná „centrální“ Customer service. Každý Bounded Context má vlastní pohled na customer, který odpovídá jeho jazyku a kontextu. Ordering vidí Customer jako adresu pro doručení a platební preferenci, Billing jako fakturačního partnera s DIČ, Support jako entitu s historií ticketů. Stejné customerId, různé modely. Martin Fowler pro tuto situaci v bliki BoundedContext (2014) používá označení polysemic concept: jeden pojem s odlišným významem v každém kontextu a s explicitním mapováním mezi nimi. Pokud se rozhodnete jeden BC označit za „source of truth“ pro identitu zákazníka, ostatní BC od něj přebírají jen customerId a vlastní atributy si modelují samy. Detail v Context Mappingu.